API de OpenAI — Inferencia con la clave de su organización
Con esta integración, las llamadas a modelos GPT que hace SecureAI se envían a la API de OpenAI con la clave de API de su organización, en lugar de pasar por los proveedores administrados por SecureAI. El consumo lo factura OpenAI a su organización o proyecto: usa sus créditos, sus descuentos, su presupuesto y sus límites de uso. SecureAI sigue en el camino de cada solicitud: DLP, políticas de modelos, auditoría y recibos firmados se aplican igual que con cualquier otro proveedor.No confundir con OpenAI Platform. Esta página conecta OpenAI como proveedor de inferencia (Administrador → Integraciones → Proveedores de IA) y usa una clave de API normal, que solo sirve para llamar a los modelos. La tarjeta OpenAI Platform de la categoría Nube usa una clave de administración para inventariar proyectos, claves y uso, y nunca envía un prompt. Son integraciones independientes: puede usar una, la otra o las dos.
Cómo funciona
- Usted crea en la plataforma de OpenAI una clave de API dedicada a SecureAI y la carga en SecureAI. Se guarda cifrada y no se vuelve a mostrar.
- Al guardar, SecureAI lee con esa clave la lista de modelos que puede llamar (
GET /v1/models, solo los modelos de chat) y asocia cada modelo GPT del catálogo de SecureAI con el id de OpenAI que lo sirve. - En cada turno de chat o tarea de un modelo GPT, SecureAI aplica DLP y la política de modelos, firma la solicitud y la envía a la Chat Completions API de OpenAI a través de su gateway SMLTP.
- La respuesta vuelve por el gateway, que inspecciona y redacta también las respuestas en streaming antes de que lleguen al usuario, y emite el recibo firmado.
Qué corre con su clave y qué no
Cuántos proveedores de inferencia puede usar
La API de OpenAI cuenta como un proveedor de inferencia más, igual que Google Vertex AI, Azure AI Foundry, Amazon Bedrock y la API de Anthropic:
Cada familia de modelos puede enrutarse a un solo proveedor. Si GPT ya corre en Azure AI Foundry o Amazon Bedrock, primero quítelo de allí: SecureAI rechaza una configuración que se superponga e indica qué familia colisiona.
Requisitos previos
- Una organización de OpenAI con facturación activa (o un proyecto con presupuesto).
- Permiso para crear claves de API en la plataforma de OpenAI (API keys).
- Permiso de administrador en la sección Integraciones de SecureAI.
- Que la política de modelos SMLTP de su organización permita al menos un modelo GPT que su clave pueda llamar (AI Gateway → Políticas). SecureAI aplica esa política también a estas llamadas.
Paso 1. Cree la clave en la plataforma de OpenAI
- En la plataforma de OpenAI, vaya a API keys y haga clic en Create new secret key.
- Póngale un nombre que la identifique (por ejemplo
SecureAI). Recomendamos una clave de proyecto: limita la clave a un proyecto, con su presupuesto, sus límites y su acceso a modelos. - Copie la clave (empieza con
sk-). OpenAI la muestra una sola vez.
Paso 2. Conecte la clave en SecureAI
-
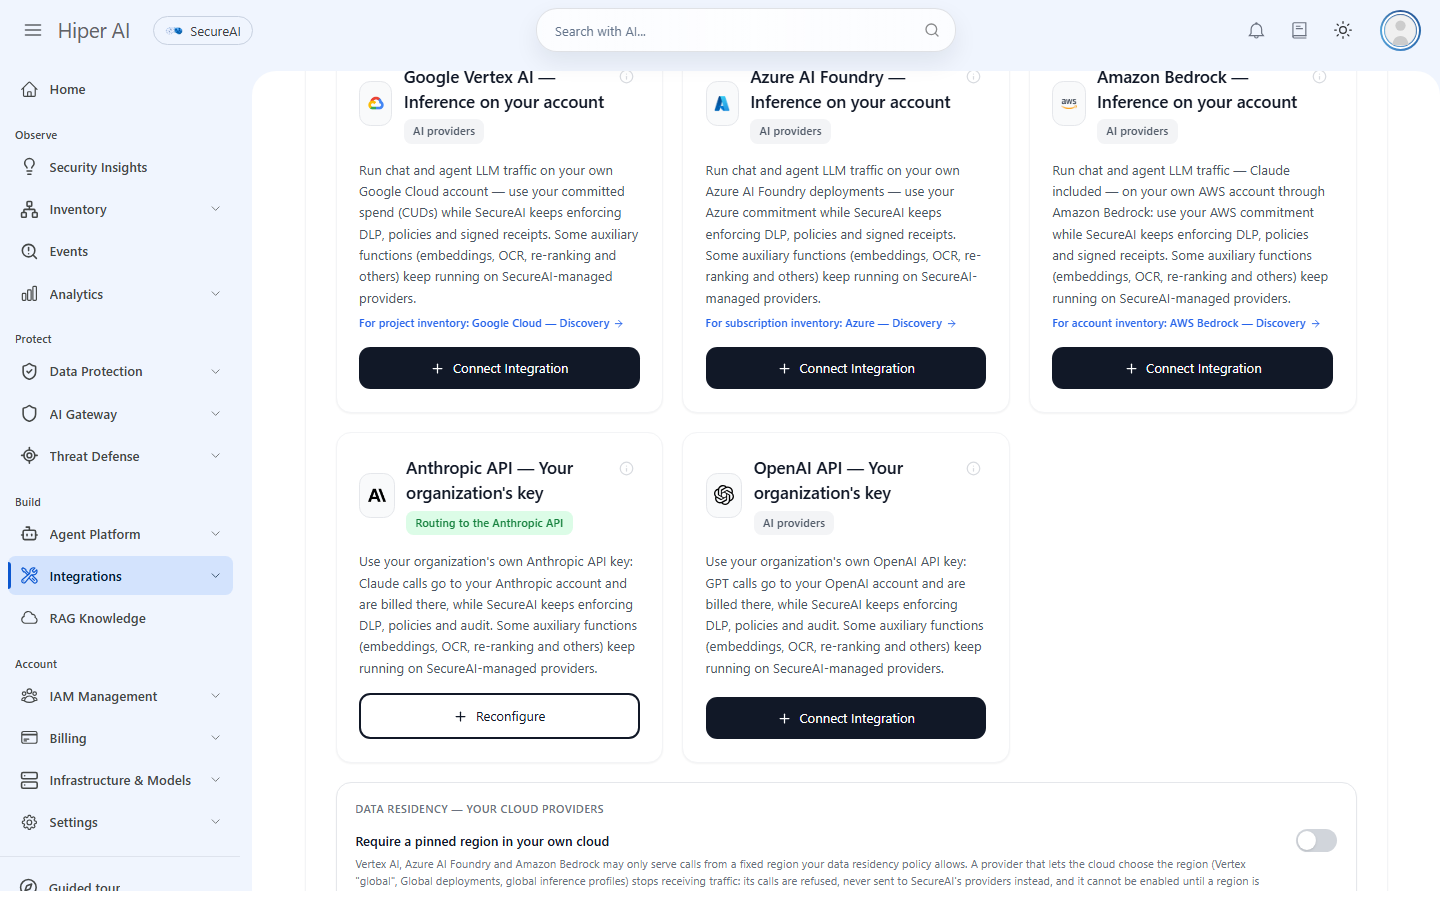
Vaya a Administrador → Integraciones → Proveedores de IA y abra API de OpenAI — La clave de tu organización.
-
Complete:
- Haga clic en Guardar.
- El campo de la clave se vacía y muestra Clave guardada (…xxxx): solo se conservan visibles los últimos 4 caracteres. La clave nunca se devuelve al navegador. Para cambiarla, escriba una nueva; si deja el campo vacío, se conserva la guardada.
- Modelos que tu clave puede llamar muestra los modelos de chat de su cuenta. Use Actualizar cuando OpenAI habilite modelos nuevos para su clave o proyecto.
- Todavía no se enruta tráfico: la integración se guarda apagada para que pueda probarla antes. La tarjeta muestra Configurado · sin enrutar a API de OpenAI.
Paso 3. Elija qué corre con su clave
En Qué corre en API de OpenAI hay dos modos:- Solo estas familias de modelos (por defecto, con OpenAI seleccionado): los modelos GPT corren con su clave; el resto sigue en los proveedores de SecureAI o en otra nube conectada.
- Reasignar todo a API de OpenAI: todas las llamadas a LLM corren con su clave. Los modelos que OpenAI no ofrece (Claude, Gemini…) los responden los modelos de OpenAI por defecto.
openai/gpt-5.2 → gpt-5.2) o, si su clave solo tiene la versión con fecha, esa (gpt-4.1-2025-04-14). Si su clave no tiene un modelo, ese modelo queda oculto para los usuarios (o va a SecureAI si permitió el fallback).
Modelos de OpenAI por defecto (elíjalos de la lista de su clave):
En Reemplazos modelo → id de OpenAI puede enviar un modelo del catálogo de SecureAI a un id de OpenAI exacto, incluido un modelo con fine-tuning (
ft:gpt-4.1-mini:…). Los reemplazos tienen prioridad sobre la asociación automática.
Además hay dos opciones:
Modelos de su clave que el catálogo no lista
Los modelos de chat que su clave puede llamar y el catálogo de SecureAI no tiene aparecen debajo del interruptor Ofrecer los modelos de tu API de OpenAI que SecureAI no lista, si su despliegue ofrece modelos propios de la nube. Puede desmarcar los que no quiera ofrecer, o apagar el interruptor. Para que los usuarios puedan elegirlos en el chat (sección Tu API de OpenAI del selector de modelos), agréguelos a la política de modelos SMLTP en AI Gateway → Políticas: se listan en la misma sección. Corren solo con su clave, nunca en los proveedores de SecureAI, aunque haya permitido el fallback.Paso 4. Pruebe y active
- Haga clic en Probar conexión. Envía una solicitud mínima (un token) a cada modelo por defecto, por el mismo camino que usará el tráfico real: gateway, política de modelos y recibos incluidos. Si todavía no eligió modelos por defecto, prueba el modelo GPT más barato que su clave puede llamar y su política de modelos SMLTP permite. La prueba se factura a su cuenta de OpenAI (una fracción de centavo).
- Revise Vista previa del enrutamiento: para cada modelo del catálogo, muestra si lo servirá Tu clave de API de OpenAI (y con qué id), otra nube conectada o SecureAI, y cuáles quedarán ocultos para los usuarios.
- Cuando la prueba pase, encienda Enrutar tráfico a API de OpenAI y haga clic en Guardar. Si no guarda, el interruptor no queda activo.
- La tarjeta pasa a verde: Enrutando a API de OpenAI.
Residencia de datos
SecureAI no puede fijar en cada solicitud la región donde OpenAI procesa una llamada. Por eso, si su organización activa Require a pinned region in your own cloud (debajo de las tarjetas de proveedores, en Administrador → Integraciones → Proveedores de IA):- No se puede habilitar el enrutamiento a la API de OpenAI.
- Si ya estaba habilitado, sus llamadas se rechazan. Nunca se envían a los proveedores de SecureAI en su lugar.
Qué se factura y a quién
- El consumo lo factura OpenAI a su organización o proyecto, con sus créditos y descuentos. Los límites de velocidad y el presupuesto son los de su organización o proyecto de OpenAI.
- SecureAI muestra el costo de esos turnos como una estimación a precio de lista solo para analítica; la cifra real puede ser distinta.
- Estos turnos no cuentan para el tope de gasto de las licencias, salvo que active Aplicar el tope de gasto de cada licencia a los turnos facturados a tu clave.
Seguridad y cumplimiento
- La clave es de solo escritura. Se guarda cifrada y nunca vuelve al navegador, ni siquiera a un administrador: solo se ven sus últimos 4 caracteres. No aparece en el registro de actividad.
- El camino sigue protegido. Cada llamada pasa por el gateway SMLTP de SecureAI: política de modelos, DLP sobre el prompt y sobre la respuesta (también en streaming), token de autorización por solicitud y recibo firmado verificable. El gateway reenvía su clave a OpenAI y no guarda ninguna propia.
- Falla cerrado. Si la clave no se puede leer, OpenAI la rechaza o un modelo no está disponible para su clave, la solicitud se rechaza; no se envía a otro proveedor salvo que usted haya permitido el fallback.
- Separada de las claves de SecureAI. Las llamadas que paga su clave usan un carril propio, distinto del que SecureAI usa con su propia cuenta.
- Auditoría. Guardar, probar o desconectar la integración queda en el registro de actividad, siempre sin la clave.
Desconectar y revocar
Desconectar (pie del panel) elimina la configuración y la clave guardada. Desde ese momento, todo el tráfico que atendía su clave vuelve a los proveedores administrados por SecureAI. También puede apagar solo Enrutar tráfico a API de OpenAI para pausar el enrutamiento conservando la conexión. Para revocar el acceso de SecureAI del lado de OpenAI, elimine la clave en la plataforma de OpenAI (API keys).Solución de problemas
Estos son los motivos que muestra Probar conexión:
Errores que pueden ver los usuarios en el chat:
Si una llamada falla por un motivo que solo un administrador puede resolver (clave revocada, cuota agotada, modelo no disponible), SecureAI avisa a los administradores por correo, en la tarjeta de la integración y en la campana de notificaciones.
Limitaciones actuales
- Sin residencia de datos fija (vea arriba).
- gpt‑oss no corre con su clave: OpenAI no aloja esos modelos.
- Embeddings, re-ranking, OCR, asistente de administración, generación de imágenes y voz en tiempo real siguen en proveedores administrados por SecureAI.
Relacionado
- API de Anthropic — Inferencia con la clave de su organización
- Azure AI Foundry — Inferencia en tu cuenta: GPT en su recurso de Azure, con residencia de datos.
- OpenAI Platform: inventario de proyectos, claves y uso de OpenAI.
- Descripción general de los proveedores de IA en la nube
- Recibos firmados