Google Vertex AI — Inferencia en tu cuenta
Con esta integración, las llamadas a modelos de lenguaje (LLM) de SecureAI se ejecutan en su propio proyecto de Google Cloud en lugar de en los proveedores administrados por SecureAI. El consumo se factura directamente a su cuenta de Google, así que puede aprovechar su gasto comprometido (CUDs) y descuentos negociados. SecureAI sigue en el camino de cada solicitud: DLP, políticas de modelos, residencia de datos y recibos firmados se aplican igual que con cualquier otro proveedor.No confundir con la otra tarjeta de Google Cloud. Esta página conecta Vertex AI como proveedor de inferencia (Admin → Integraciones → Proveedores de IA). La tarjeta Google Cloud — Descubrimiento (categoría Nube) solo inventaría el proyecto en modo lectura y nunca envía un prompt; se describe en Google Cloud — Descubrimiento. Pueden usarse con el mismo proyecto, pero son independientes y piden permisos distintos.
Qué corre en Vertex y qué no
Modelos disponibles hoy: Gemini, los modelos abiertos servidos como MaaS en Vertex (gpt-oss, DeepSeek, Llama y Qwen) y los modelos de socios de Google Claude y Mistral (y también AI21), que SecureAI llama por el endpoint de modelos de socios de Vertex (
rawPredict / streamRawPredict). Claude y Mistral corren en su Vertex solo si usted elige su familia; vea Claude y Mistral, más abajo.
Cuántos proveedores de nube puede usar
Con más de un proveedor habilitado, cada uno atiende familias de modelos distintas: una familia solo puede tomarla un proveedor activo, y solo un proveedor puede estar en Remapear todo. Al guardar la integración encendida, SecureAI la rechaza en dos casos y lo explica en el panel:
Requisitos previos
- Un proyecto de Google Cloud con facturación activa.
- La Agent Platform API (Vertex AI API) habilitada en ese proyecto (el servicio
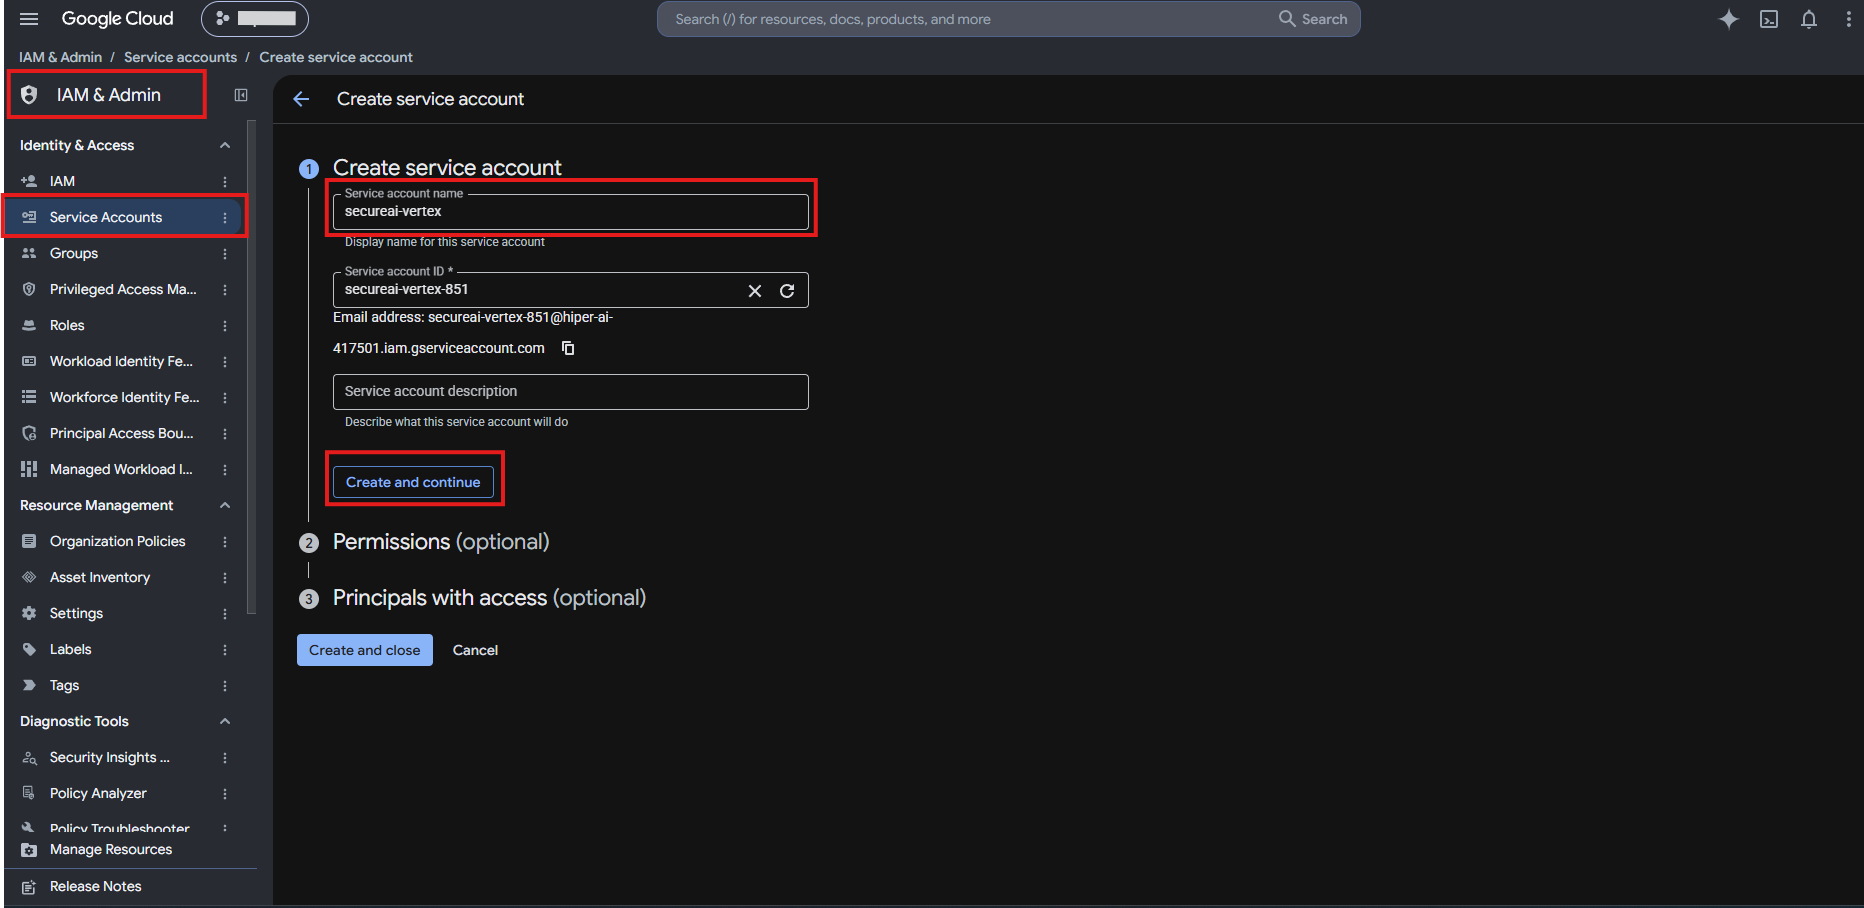
aiplatform.googleapis.com). - Una cuenta de servicio de su proyecto con el rol Agent Platform User (
roles/aiplatform.user), y una de estas dos formas de que SecureAI actúe con ella:- Opción A — clave JSON de esa cuenta de servicio.
- Opción B — sin clave (impersonación): usted le otorga a la cuenta de servicio de SecureAI que muestra el panel el rol Service Account Token Creator (
roles/iam.serviceAccountTokenCreator) sobre su cuenta de servicio, y no se guarda ninguna clave. Esta opción está disponible solo si su despliegue de SecureAI la ofrece; si no, el panel la muestra deshabilitada con el aviso El acceso sin clave no está habilitado en este despliegue.
- Permiso de administrador en la sección Integraciones de SecureAI. Con permiso de lectura puede ver la configuración pero no cambiarla.
Paso 1. Prepare el proyecto en Google Cloud
Puede hacerlo con la línea de comandos (rápido) o desde la consola (con capturas). Los pasos 1 a 3 son iguales para las dos opciones de autenticación; el paso 4 (la clave JSON) es solo para la opción A.- gcloud (Cloud Shell)
- Consola de Google Cloud
Desde Cloud Shell o con
gcloud instalado. Reemplace MI_PROYECTO por el ID real del proyecto: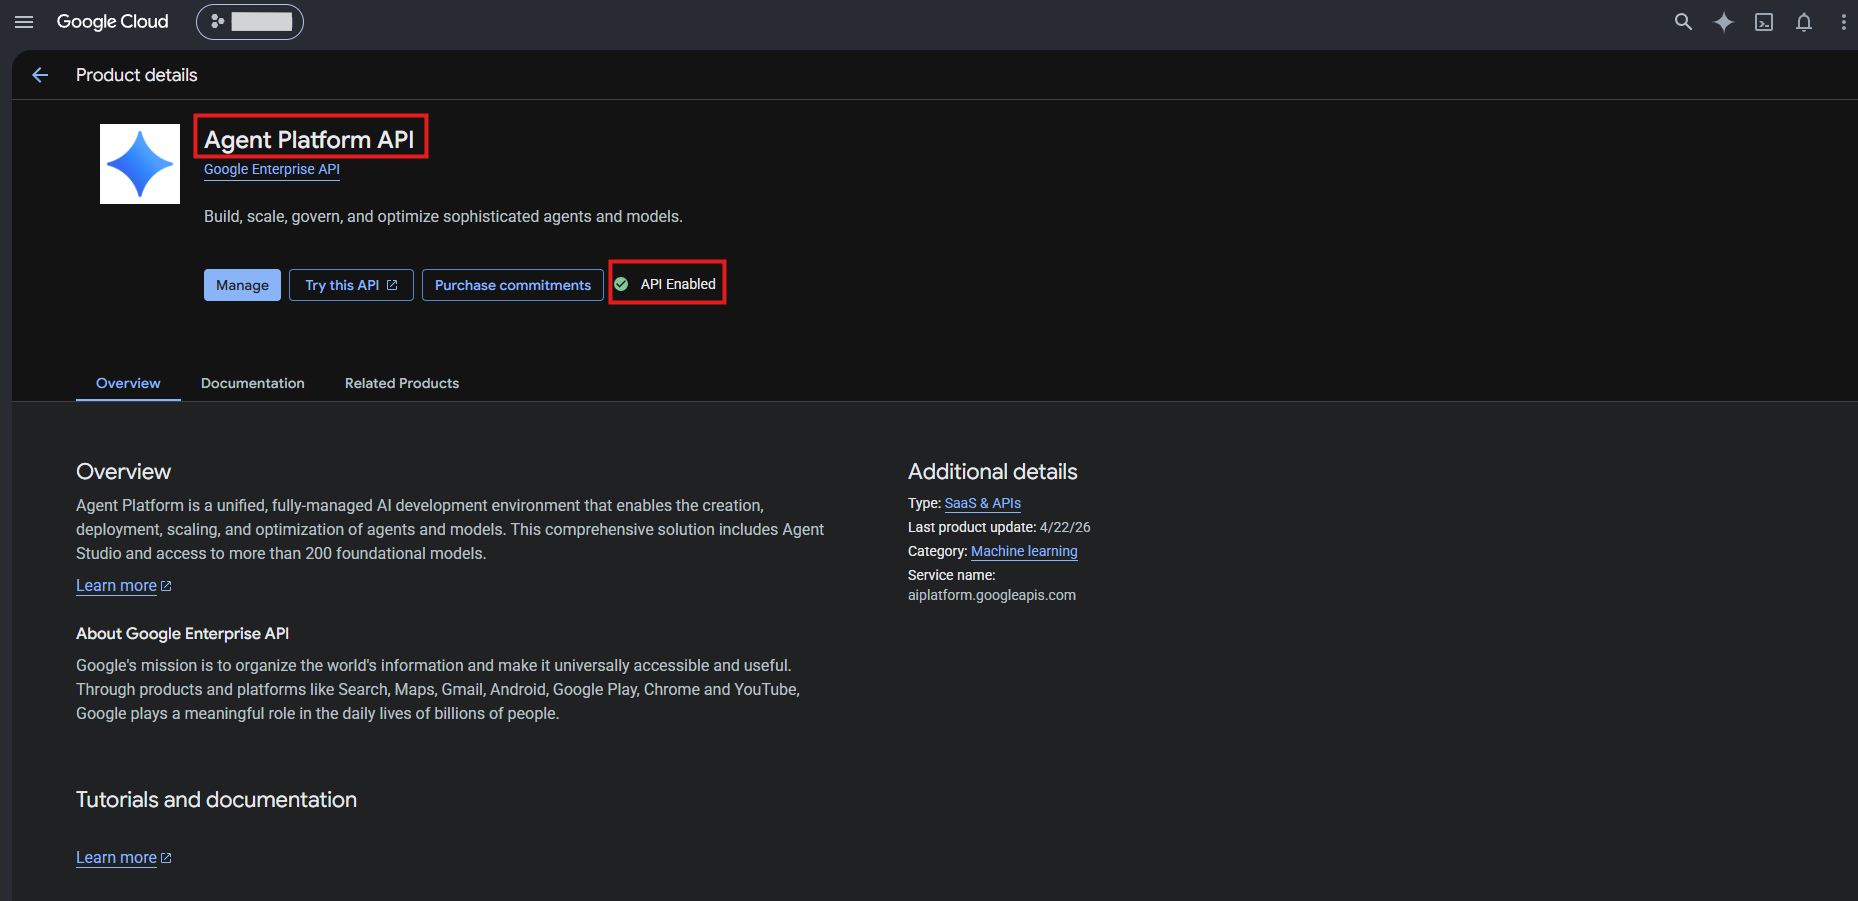
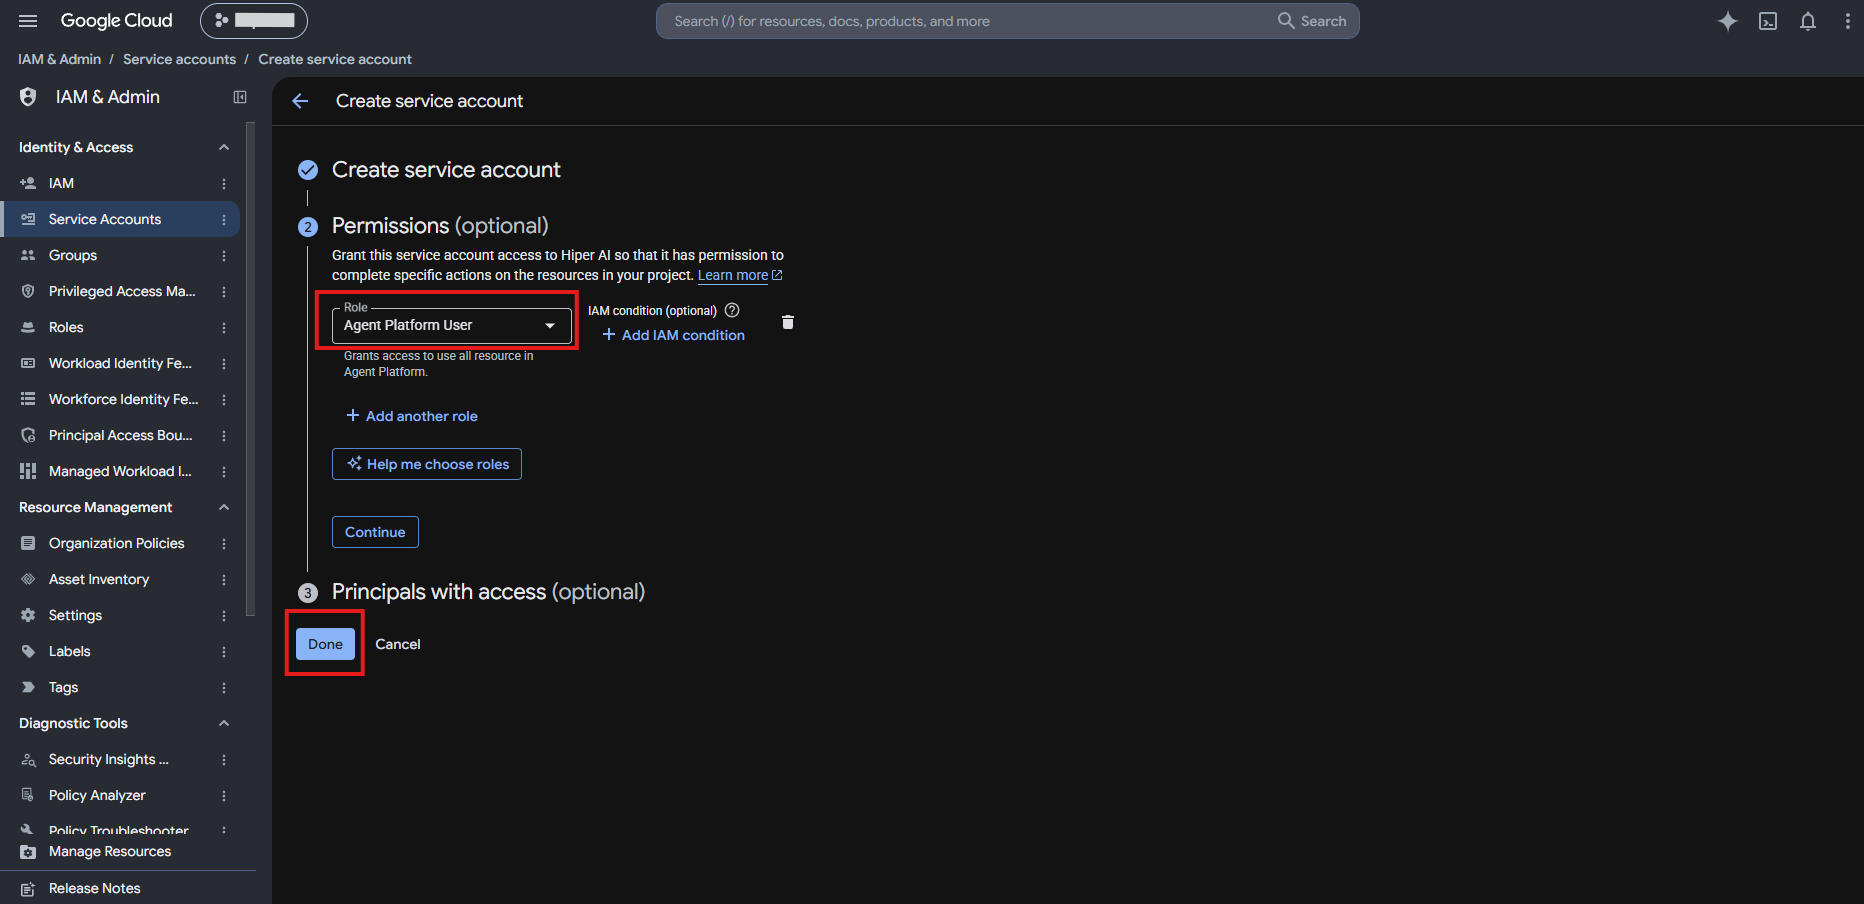
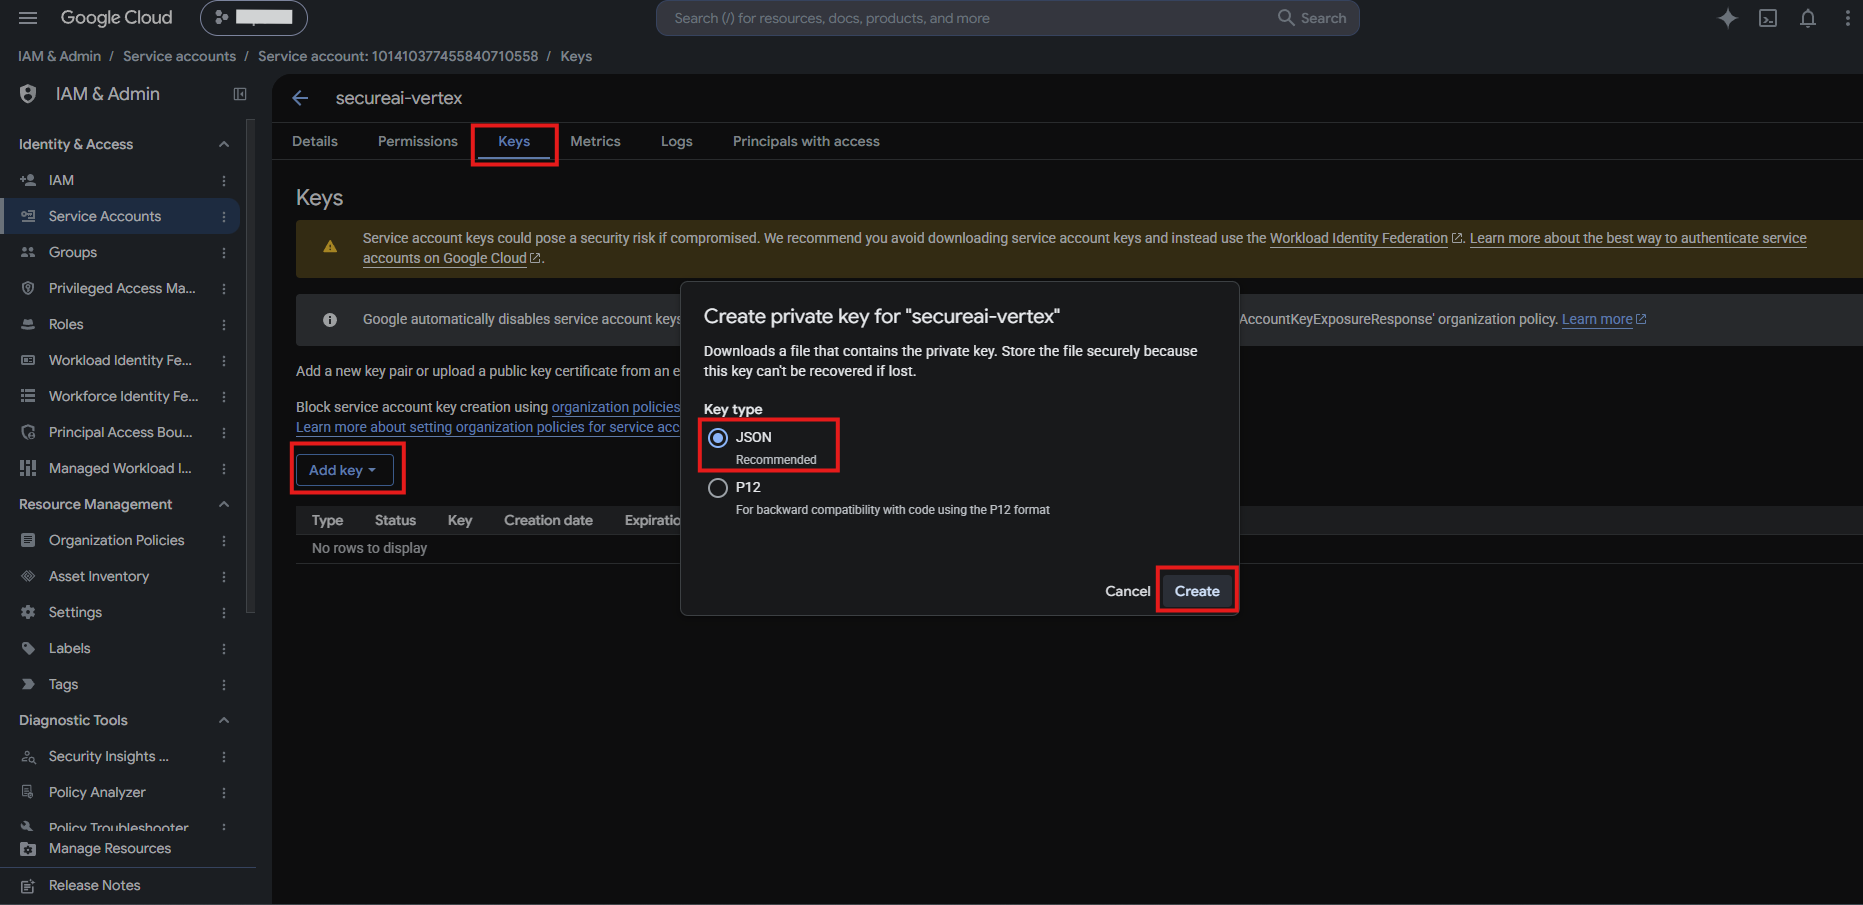
Opción B: autorice a SecureAI sin clave
Con la opción B no se crea ninguna clave. En su lugar:- En SecureAI, abra el panel de Vertex AI (vea el paso 2), elija Sin clave (impersonación) e ingrese el email de su cuenta de servicio en Tu service account a impersonar.
-
El panel muestra el comando que hay que ejecutar, ya completo con la cuenta de servicio de SecureAI de su despliegue. Cópielo con Copiar y ejecútelo en Cloud Shell. Tiene esta forma:
El rol se otorga sobre su cuenta de servicio, no sobre el proyecto: SecureAI solo puede actuar como esa cuenta, que a su vez solo tiene
roles/aiplatform.user.
Modelos abiertos (Llama, DeepSeek, Qwen, gpt-oss)
Gemini no requiere nada más. Para usar además Llama, DeepSeek, Qwen o gpt-oss, acepte primero los términos de cada modelo en Vertex AI → Model Garden. Estos modelos abiertos necesitan una región concreta (por ejemplous-central1); con global pueden no estar disponibles.
Claude y Mistral
Para usar Claude o Mistral, habilite cada modelo en Vertex AI → Model Garden y acepte los términos de Anthropic o de Mistral para ese modelo. Después, en el paso 3, marque la familia Claude o Mistral. SecureAI solo envía estos modelos a su Vertex cuando usted elige su familia, porque no puede saber si su proyecto los tiene habilitados: Remapear todo por sí solo nunca los envía ahí.- SecureAI usa el nombre que les da Vertex, con guiones: por ejemplo
anthropic/claude-sonnet-4-6. Un modelo que necesita su versión con fecha (claude-…@20250929) se declara en Modelos de su nube que SecureAI no lista, más abajo. - Según la documentación de Google, Claude en Vertex está disponible en regiones específicas y en el endpoint
global. Consulte las regiones en la documentación de Google sobre Claude en Vertex AI.
Paso 2. Conecte el proyecto en SecureAI
- Vaya a Administrador → Integraciones, abra la categoría Proveedores de IA y haga clic en la tarjeta Google Vertex AI — Inferencia en tu cuenta.
-
En Conexión, complete:
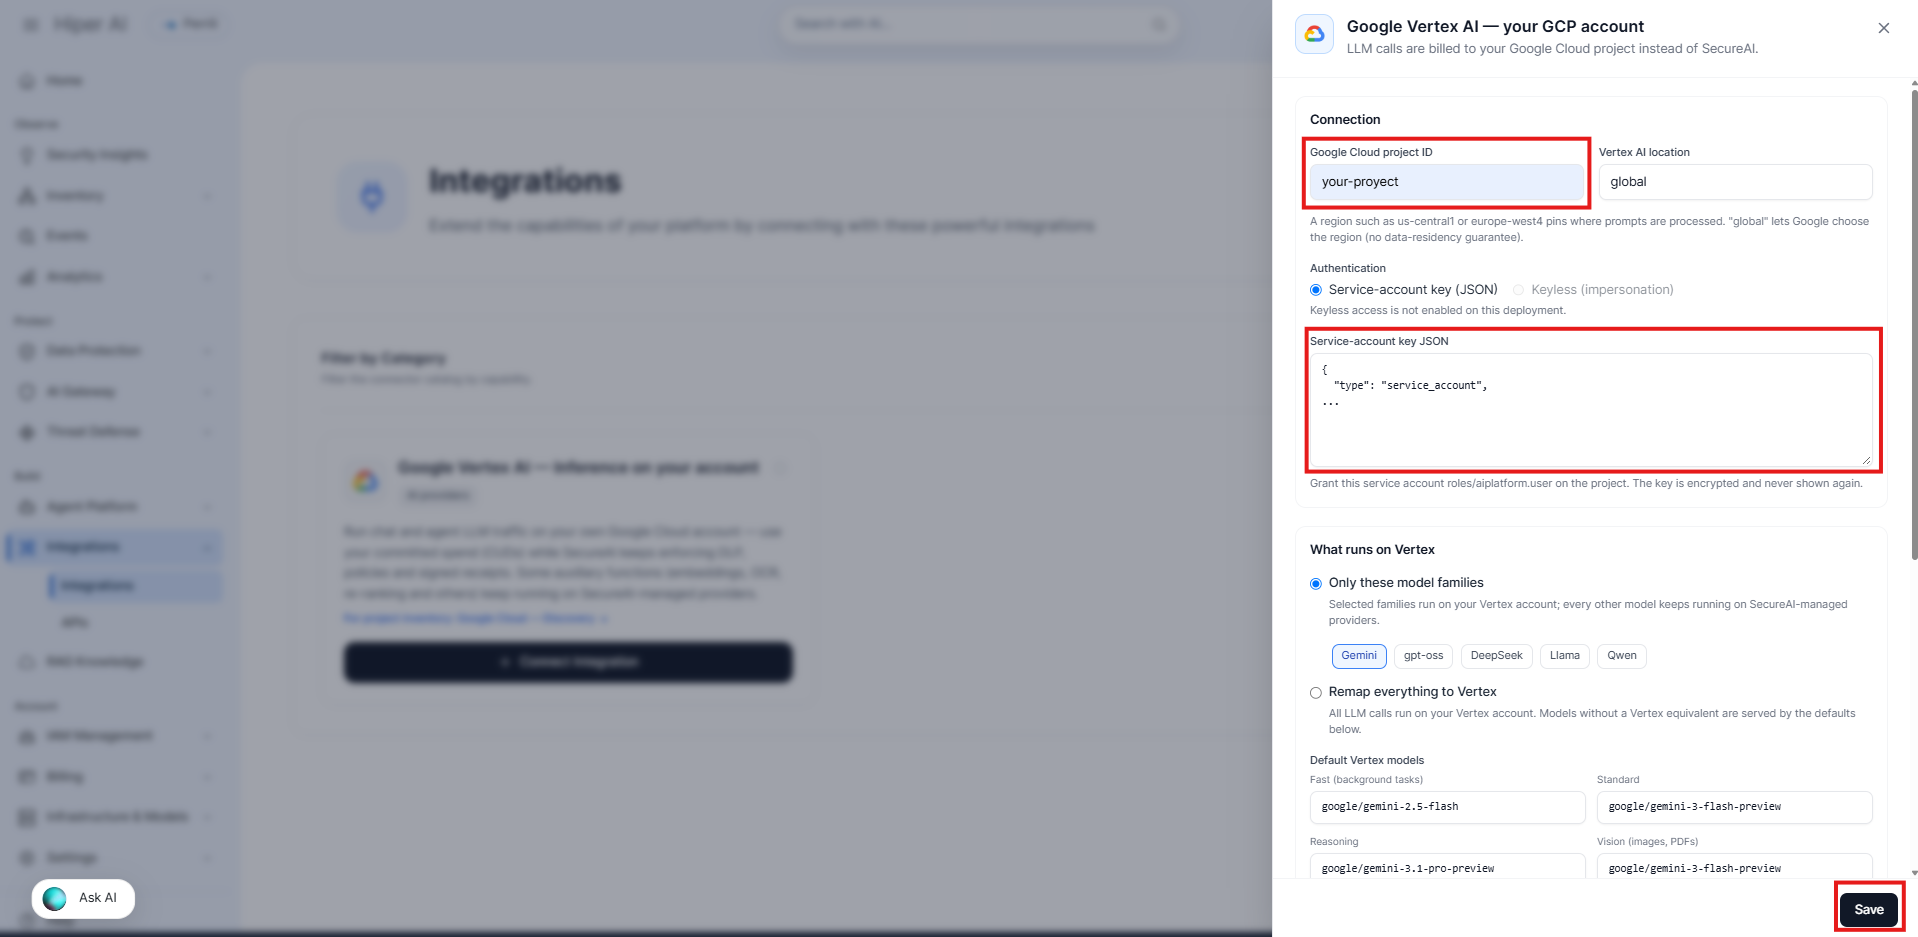
- Haga clic en Guardar. Todavía no se enruta tráfico: la integración se guarda apagada para que pueda probarla antes.
Recomendación para el primer día: deje el modo Solo estas familias de modelos con solo Gemini, los modelos por defecto sin cambios, y apagados el fallback y el tope de gasto por asiento. Es lo más predecible. Deje Remapear todo para cuando esto ya esté validado.
Con la opción A, la clave pegada nunca vuelve a mostrarse. Para reemplazarla, pegue una nueva; si deja el campo vacío al guardar, se conserva la actual.
Paso 3. Elija qué corre en Vertex
En Qué corre en Vertex hay dos modos:- Solo estas familias de modelos — las familias que marque (Gemini, gpt-oss, DeepSeek, Llama, Qwen, Claude, Mistral) corren en su Vertex; el resto de los modelos sigue en los proveedores de SecureAI. Es el modo más conservador para empezar (por defecto: solo Gemini).
- Remapear todo a Vertex — todas las llamadas a LLM corren en su Vertex. Los modelos sin equivalente en Vertex los sirve un modelo por defecto. Claude y Mistral van a Vertex solo si marca su familia (vea Claude y Mistral, en el paso 1).
Además hay dos opciones:
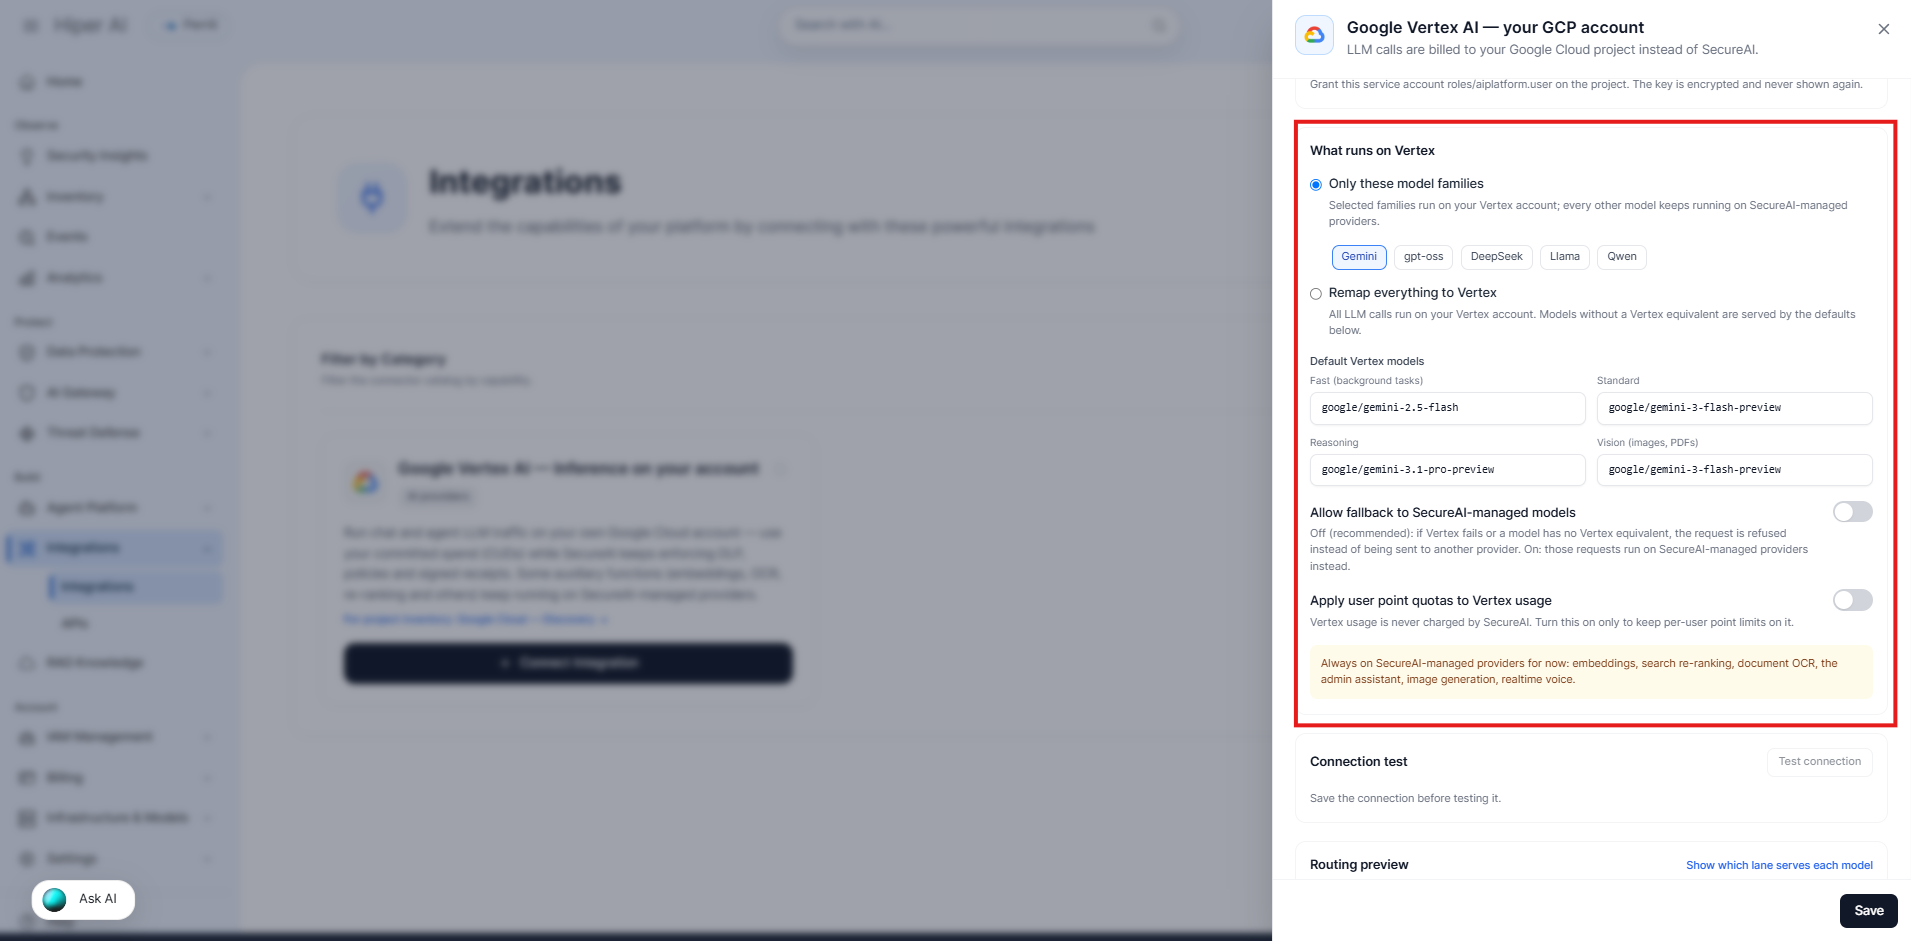
Los modelos disponibles dependen de la ubicación. Los modelos por defecto (varios en versión preview) pueden no existir en todas las regiones. Si la prueba de conexión devuelve Modelo no disponible en esta ubicación, elija otra región o reemplace los modelos por defecto por unos que su región sirva. Los modelos abiertos (MaaS) requieren aceptar sus términos en Vertex AI Model Garden y una región concreta. Claude y Mistral requieren que el modelo esté habilitado en Model Garden.
Paso 4. Pruebe la conexión
- Con la integración guardada, en Prueba de conexión haga clic en Probar conexión.
-
SecureAI envía una solicitud mínima a cada modelo por defecto, por el mismo camino que usará el tráfico real (gateway, políticas y recibos incluidos), y muestra el resultado de cada uno con su latencia.
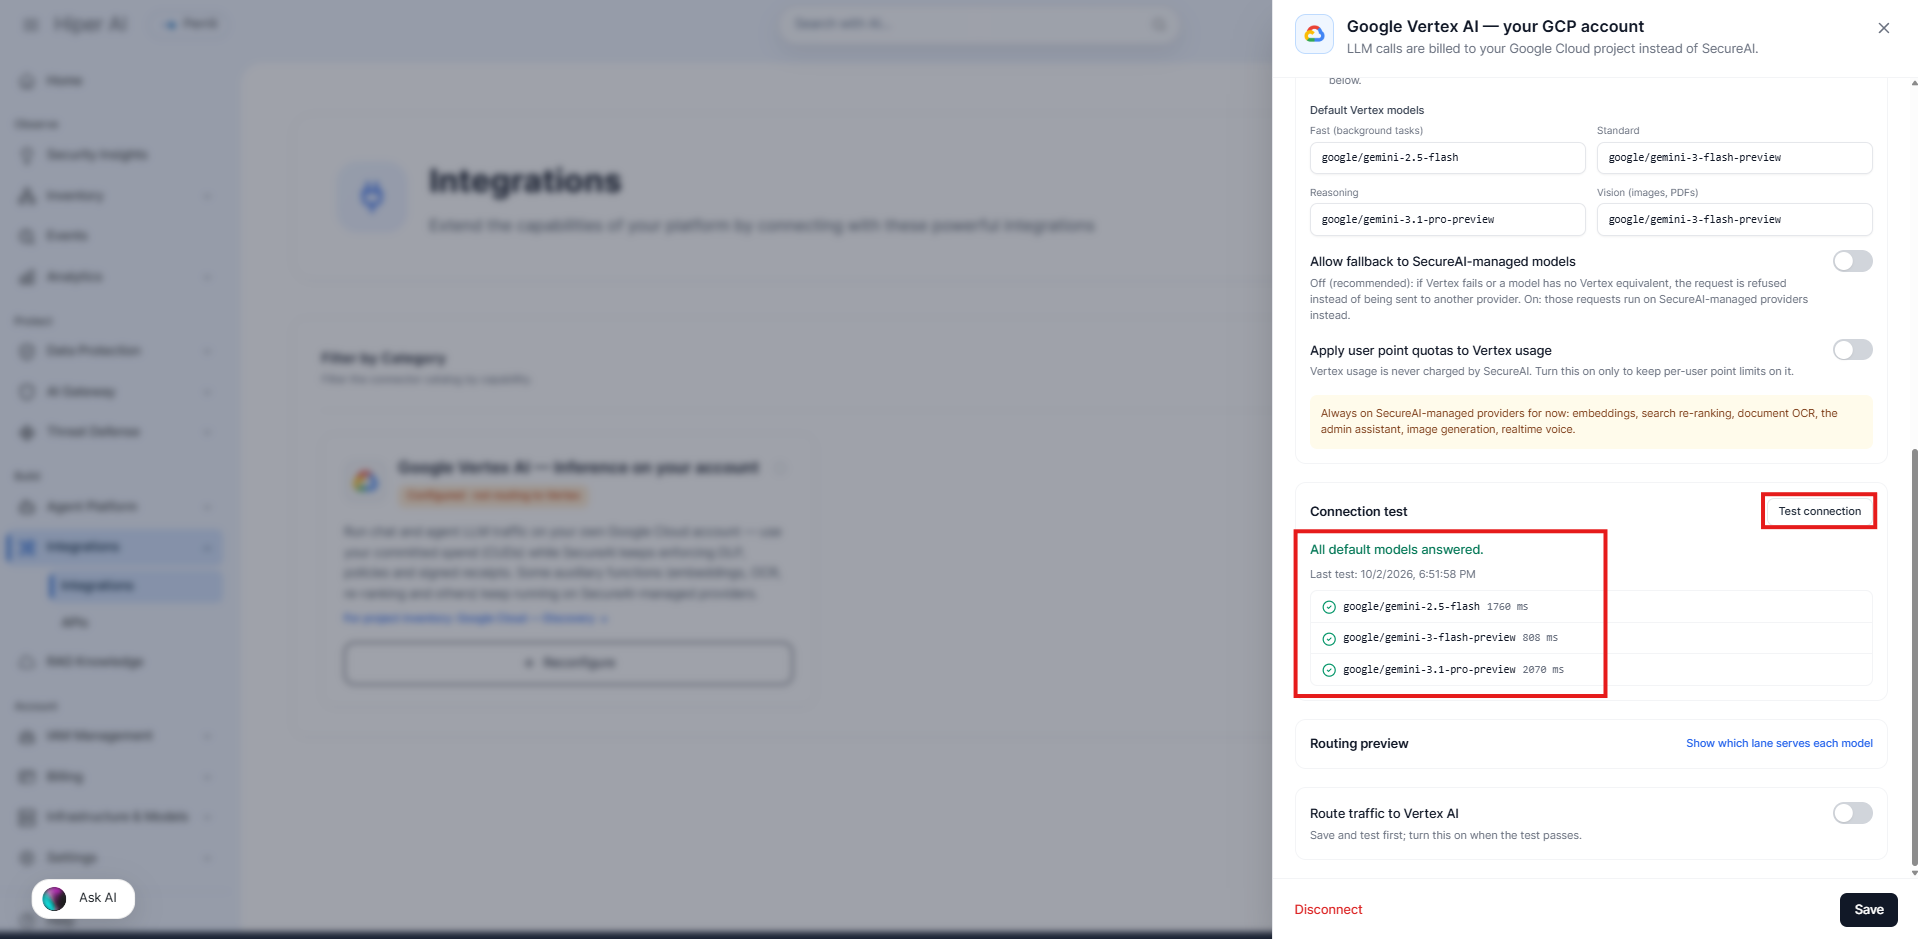
- Si algún modelo falla, el panel indica el motivo. Consulte la sección Solución de problemas al final de esta página.
Qué más puede hacer la identidad
La prueba también verifica qué más puede hacer la identidad de la conexión en el proyecto, conprojects:testIamPermissions y el mismo token del carril: no hace falta ningún rol extra y no cambia nada. El panel muestra uno de estos avisos:
La prueba envía unas pocas solicitudes de un token y se factura a su cuenta de Google (centavos).
Paso 5. Revise el enrutamiento y active
- Abra Vista previa del enrutamiento → Ver qué carril sirve cada modelo. Muestra, para cada modelo del catálogo, si lo servirá su Vertex (y con qué modelo de Vertex) o SecureAI, y cuáles quedarán ocultos para los usuarios. La vista previa simula la integración encendida, así que puede revisar el efecto antes de activarla.
-
Cuando la prueba pase, encienda Enrutar tráfico a Vertex AI y haga clic en Guardar otra vez. Si no guarda, el interruptor no queda activo. Para activarla se exige tener el proyecto y una credencial configurados. Si su plan no admite otro proveedor de nube o el enrutamiento se superpone con otro, SecureAI lo rechaza y explica por qué (vea Cuántos proveedores de nube puede usar, más arriba).
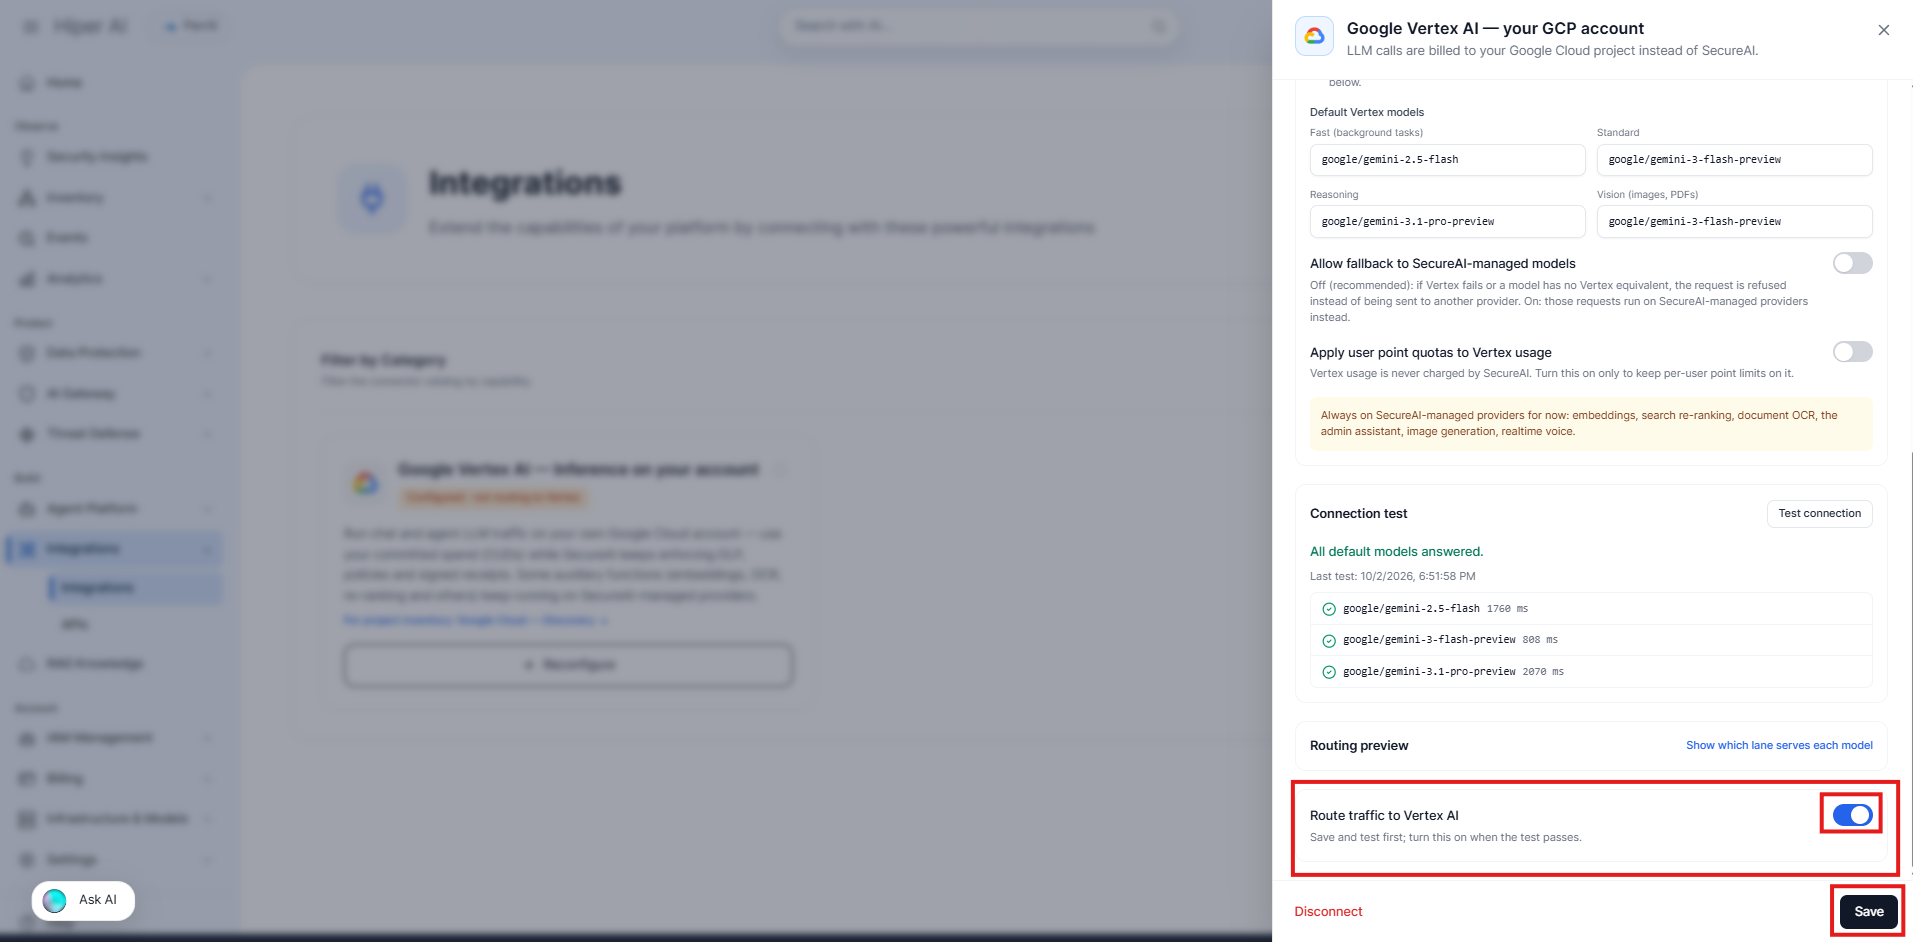
- La tarjeta pasa a verde: Enrutando a Vertex. Si está guardada pero apagada, muestra en ámbar Configurado · sin enrutamiento a Vertex.
Paso 6. Verifique en el selector de modelos
Cuando la integración está activa, los modelos que corren en su Vertex muestran el logo de Google Cloud junto al nombre en el selector de modelos del chat. Al pasar el mouse indica que corre en la cuenta de Vertex AI de su organización.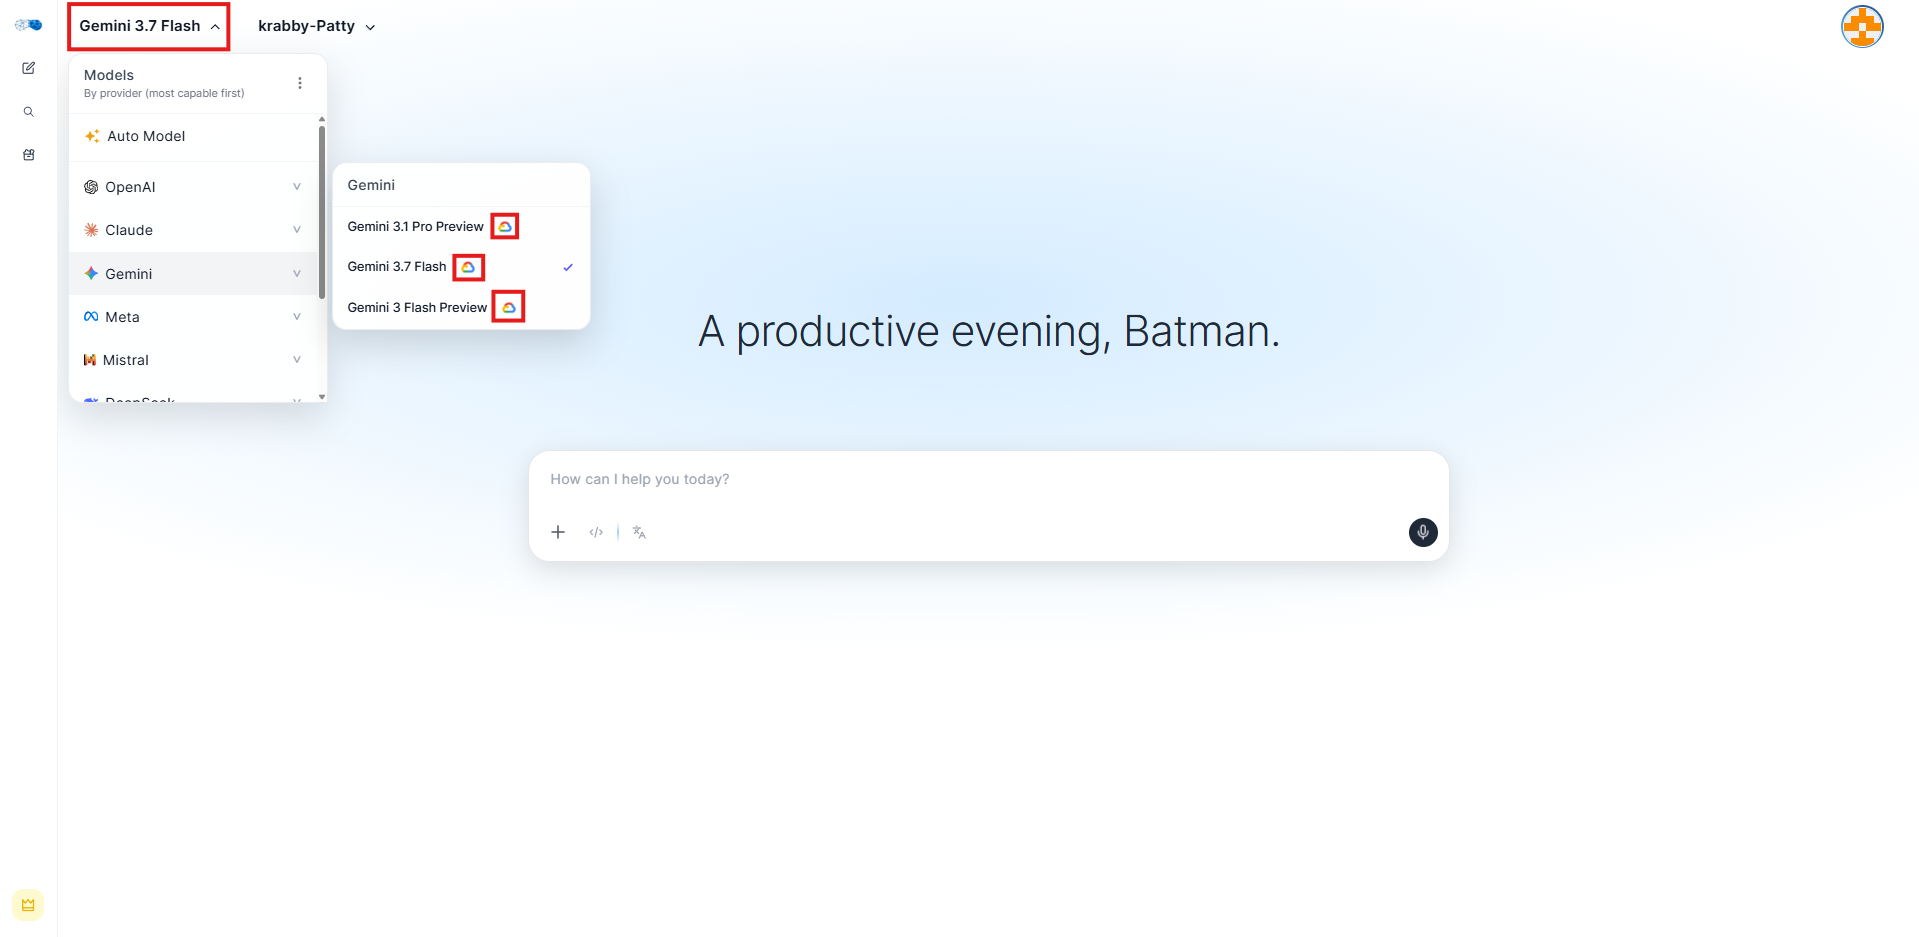
Modelos de su nube que SecureAI no lista
Su proyecto puede tener habilitados en Model Garden modelos de chat que el catálogo de SecureAI no incluye (por ejemplo un Claude más nuevo o Codestral). Cuando su despliegue de SecureAI los habilita, el chat también puede ofrecerlos:- De dónde salen. Model Garden no informa qué modelos habilitó su proyecto, así que usted los nombra en el panel de Vertex AI como
publisher/modelo(por ejemploanthropic/claude-opus-4-7omistralai/codestral-2), los agrega con Agregar, hace clic en Guardar y corre Probar conexión para verificar que cada uno responde. Un modelo al que ya llega un modelo del catálogo de SecureAI conserva su nombre del catálogo y no se repite acá. - Dónde aparecen. En el selector de modelos del chat, en su propia sección: Tu Google Vertex AI. Su id empieza con
byo/gcp-vertex/. - Dónde corren. Solo en su Vertex. Nunca se envían a los proveedores administrados por SecureAI, aunque haya permitido el fallback.
- Qué cuestan. SecureAI no los cobra (no tienen precio de lista en SecureAI), así que el tope de gasto por asiento no se aplica a ellos, y cualquier asiento puede usarlos. Google factura el consumo a su cuenta, como el resto.
- Misma gobernanza. Pasan por la política de modelos, los bloqueos de proveedor y de fabricante, el DLP, los recibos firmados y la auditoría. Si su política de modelos enumera los modelos permitidos, agréguelos en el editor de la política, donde aparecen en la sección de su nube.
- Qué admite cada uno. Las herramientas, las imágenes y el tamaño de contexto salen de los datos que el proveedor publica sobre el modelo. Si un modelo no admite herramientas o imágenes, el chat no se las ofrece, y las imágenes nunca se envían a otro proveedor para que las describa.
Qué se factura y a quién
- El consumo de LLM lo factura Google a su cuenta, no SecureAI. Verá el cargo en su facturación de Google Cloud, con sus descuentos y CUDs aplicados.
- SecureAI muestra el costo de los turnos servidos en Vertex como una estimación a precio de lista solo para analítica. Es una referencia: no incluye sus descuentos, así que la cifra real de Google puede ser menor.
- Los turnos servidos en su Vertex no cuentan contra el tope de gasto del asiento de cada usuario, salvo que active Aplicar el tope de gasto de cada asiento a los turnos servidos en tu cuenta. El nivel del asiento se aplica igual: un usuario solo puede usar modelos de su nivel o inferiores, aunque los sirva su Vertex.
- Un asiento Govern BYO solo puede usar modelos servidos en la infraestructura de su organización: los que atiende su Vertex (u otro proveedor de nube conectado) y los modelos autoalojados en sus servidores. Cualquier otro modelo se rechaza, y el selector no le ofrece Auto.
Seguridad y cumplimiento
- Credenciales cifradas, o ninguna. Con la opción A, la clave de la cuenta de servicio se guarda cifrada (AES-256-GCM) y nunca se devuelve al navegador, ni siquiera a un administrador; la pantalla solo muestra el correo de la cuenta. Con la opción B no se guarda ninguna clave: SecureAI le pide a Google tokens de corta duración que actúan como su cuenta de servicio.
- El camino sigue protegido. Cada llamada pasa por el gateway SMLTP de SecureAI: DLP, token de autorización firmado por solicitud y recibo firmado verificable.
- Residencia de datos. Con una región fija (por ejemplo
europe-west4), SecureAI envía cada solicitud al endpoint regional de esa región y aplica las políticas de residencia de su organización. Dónde procesa Google la solicitud depende de sus compromisos de residencia de datos. - Falla cerrado. Si no se puede leer la configuración o obtener el token de Google, la solicitud se rechaza; no se envía a otro proveedor salvo que usted haya permitido el fallback.
- Auditoría. Guardar, probar o desconectar la integración queda en el registro de actividad, con los nombres de los campos cambiados y nunca con la clave.
- Mínimo privilegio a la vista. La prueba de conexión verifica qué más puede hacer la identidad de la conexión en el proyecto y advierte si tiene permisos fuera de IA (vea Qué más puede hacer la identidad, en el paso 4).
- Permisos mínimos. Para inferencia basta
roles/aiplatform.user; la integración no necesita leer su IAM ni su facturación.
Desconectar
Desconectar (pie del panel) elimina la configuración y la clave guardada. Desde ese momento, todo el tráfico vuelve a los proveedores administrados por SecureAI. También puede apagar solo el interruptor Enrutar tráfico a Vertex AI para pausar el enrutamiento conservando la conexión. Después, retire también el acceso en Google Cloud:- Opción A: si dejó de usar la clave, revóquela (Cuentas de servicio → Claves).
- Opción B: quite el rol
roles/iam.serviceAccountTokenCreatorque le otorgó a la cuenta de servicio de SecureAI sobre su cuenta de servicio (Cuentas de servicio → su cuenta → Permisos).
Solución de problemas
Estos son los motivos que muestra Probar conexión:
Errores que pueden ver los usuarios en el chat:
Limitaciones actuales
- Embeddings, re-ranking, OCR, asistente de administración, generación de imágenes y voz en tiempo real siguen en proveedores administrados por SecureAI.
- Un solo proyecto y una sola ubicación de Vertex por organización.
- La cantidad de proveedores de inferencia que puede habilitar a la vez depende del plan (Scale: 1, Enterprise: hasta 3). Consulte Azure AI Foundry — Inferencia en tu cuenta y Amazon Bedrock — Inferencia en tu cuenta.
- El proxy de Claude Code usa Anthropic de forma directa y no pasa por Vertex.
Relacionado
- Google Cloud — Descubrimiento — inventario de agentes, modelos, identidades y costos del proyecto.
- Azure AI Foundry — Inferencia en tu cuenta
- Amazon Bedrock — Inferencia en tu cuenta
- Descripción general de los proveedores de IA en la nube
- Recibos firmados