

Google Vertex AI — Inférence sur votre compte
Avec cette intégration, les appels de SecureAI aux grands modèles de langage (LLM) s’exécutent dans votre propre projet Google Cloud au lieu des fournisseurs gérés par SecureAI. L’utilisation est facturée directement sur votre compte Google, ce qui vous permet d’utiliser vos engagements de dépenses (CUD) et vos remises négociées. SecureAI reste dans le chemin de chaque requête : le DLP, les politiques de modèles, la résidence des données et les reçus signés s’appliquent exactement comme avec n’importe quel autre fournisseur.À ne pas confondre avec l’autre carte Google Cloud. Cette page connecte Vertex AI en tant que fournisseur d’inférence (Admin → Integrations → AI providers). La carte Google Cloud — Découverte (catégorie Cloud) se contente d’inventorier le projet en lecture seule et n’envoie jamais de prompt ; elle est décrite dans Google Cloud — Discovery. Vous pouvez utiliser les deux sur le même projet, mais elles sont indépendantes et demandent des autorisations différentes.
Ce qui s’exécute sur Vertex et ce qui ne s’y exécute pas
Modèles disponibles aujourd’hui : Gemini et les modèles ouverts servis en MaaS sur Vertex (gpt-oss, DeepSeek, Llama et Qwen). Claude et Mistral sur Vertex ne sont pas encore pris en charge ; ces modèles sont traités selon le paramètre de repli (voir ci-dessous).
Combien de fournisseurs cloud vous pouvez utiliser
Lorsque plusieurs fournisseurs sont activés, chacun sert des familles de modèles différentes : une famille ne peut être prise que par un seul fournisseur activé, et un seul fournisseur peut être en Remap everything. Lorsque vous enregistrez l’intégration activée, SecureAI la refuse dans deux cas et en explique la raison dans le panneau :
Prérequis
- Un projet Google Cloud avec la facturation activée.
- L’Agent Platform API (Vertex AI API) activée sur ce projet (le service
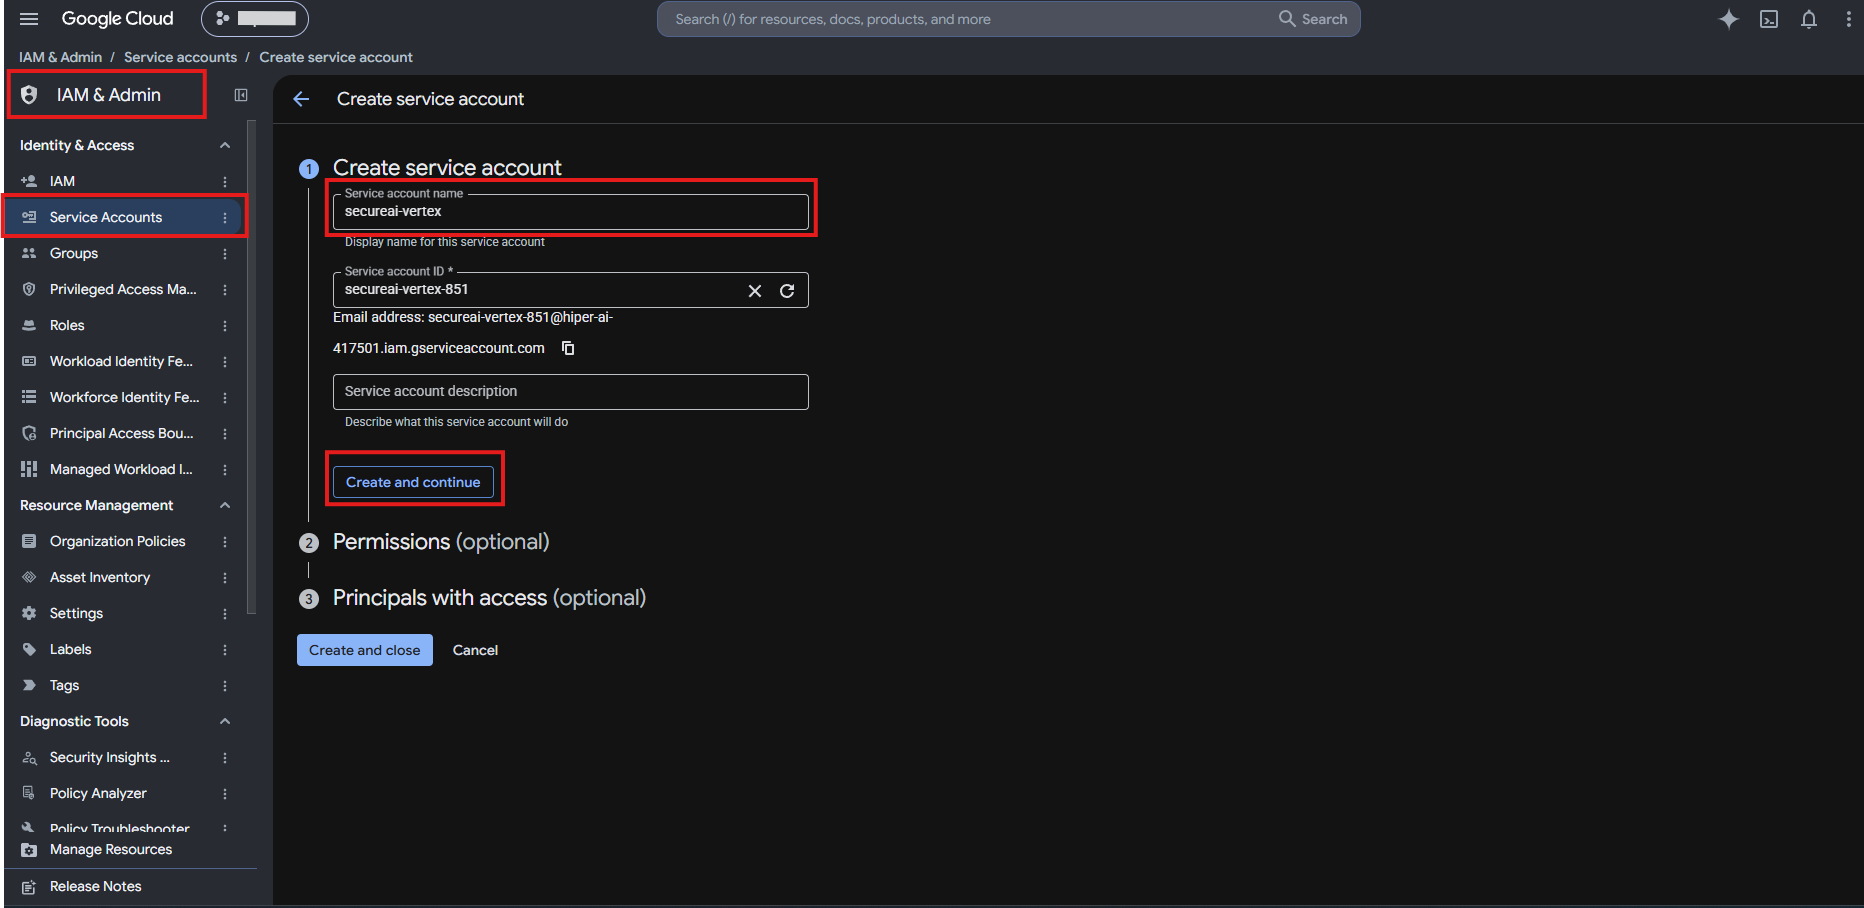
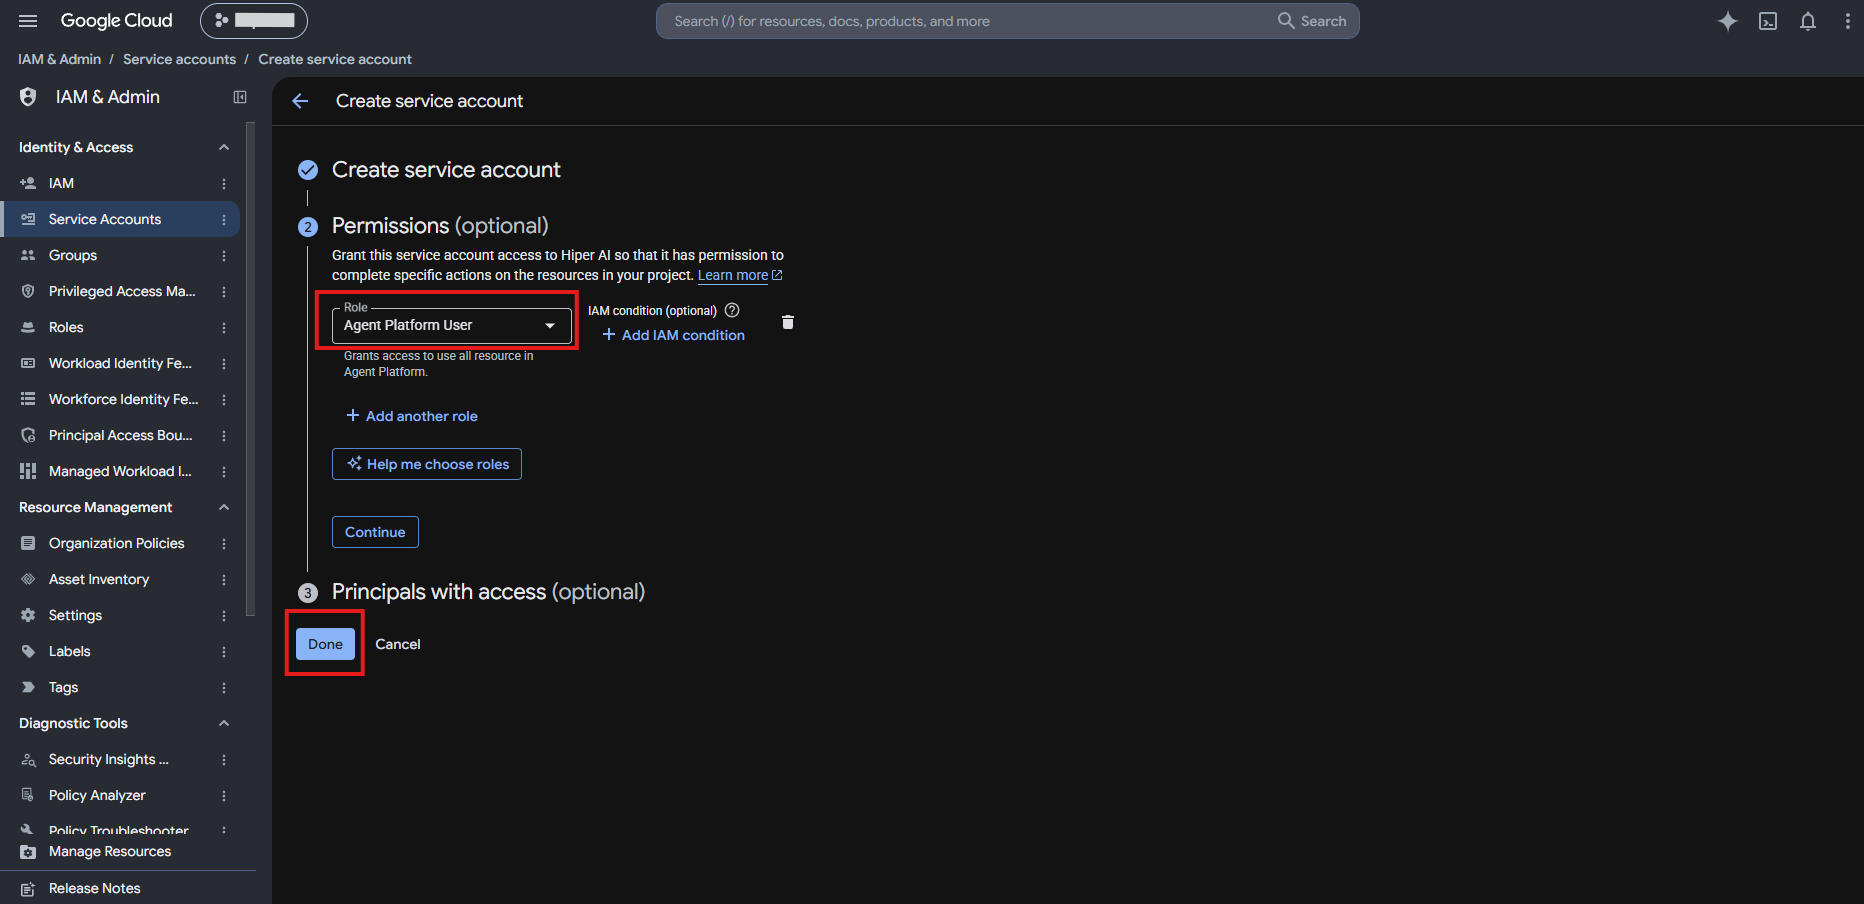
aiplatform.googleapis.com). - Un compte de service dans votre projet avec le rôle Agent Platform User (
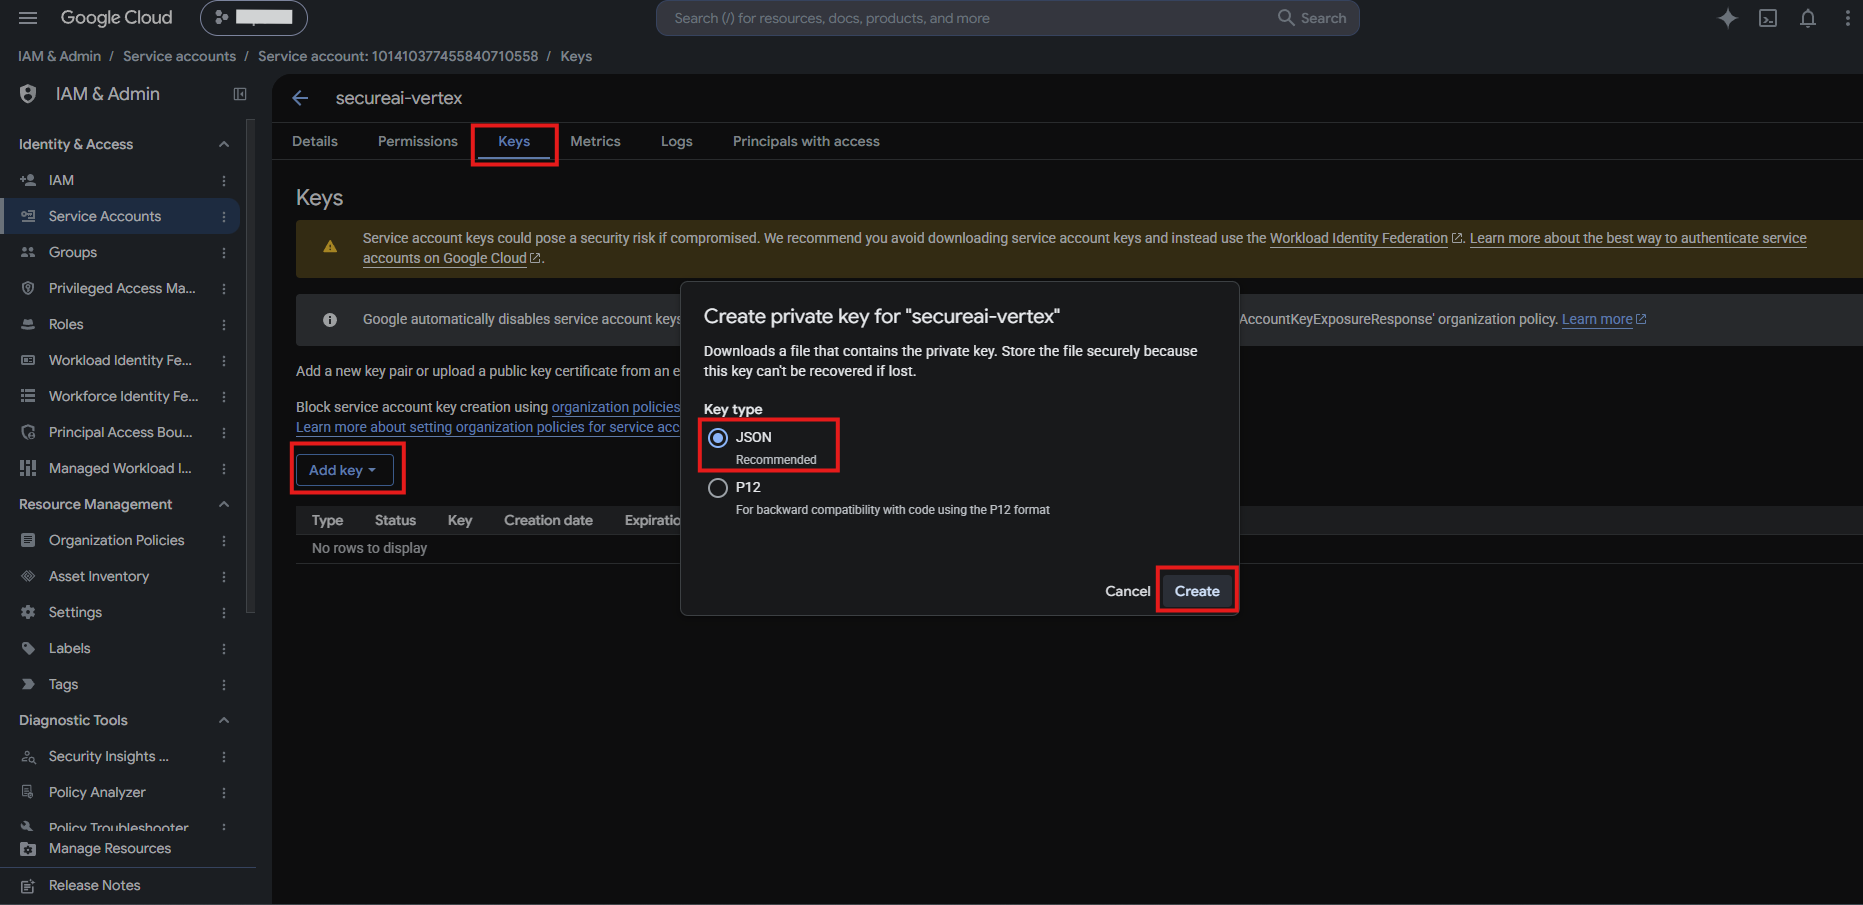
roles/aiplatform.user), et l’une de ces deux façons pour SecureAI d’agir en tant que ce compte :- Option A — une clé JSON pour ce compte de service.
- Option B — sans clé (emprunt d’identité) : vous accordez au compte de service SecureAI affiché dans le panneau le rôle Service Account Token Creator (
roles/iam.serviceAccountTokenCreator) sur votre compte de service, et aucune clé n’est stockée. Cette option n’est disponible que si votre déploiement SecureAI la propose ; sinon, le panneau l’affiche désactivée avec l’avis Keyless access is not enabled on this deployment.
- L’autorisation Admin sur la section Integrations de SecureAI. Avec l’autorisation de lecture, vous pouvez consulter la configuration mais pas la modifier.
Étape 1. Préparer le projet dans Google Cloud
Vous pouvez le faire en ligne de commande (rapide) ou depuis la console (avec captures d’écran). Les étapes 1 à 3 sont les mêmes pour les deux options d’authentification ; l’étape 4 (la clé JSON) ne concerne que l’option A.- gcloud (Cloud Shell)
- Console Google Cloud
Depuis Cloud Shell ou avec
gcloud installé. Remplacez MY_PROJECT par l’ID réel du projet :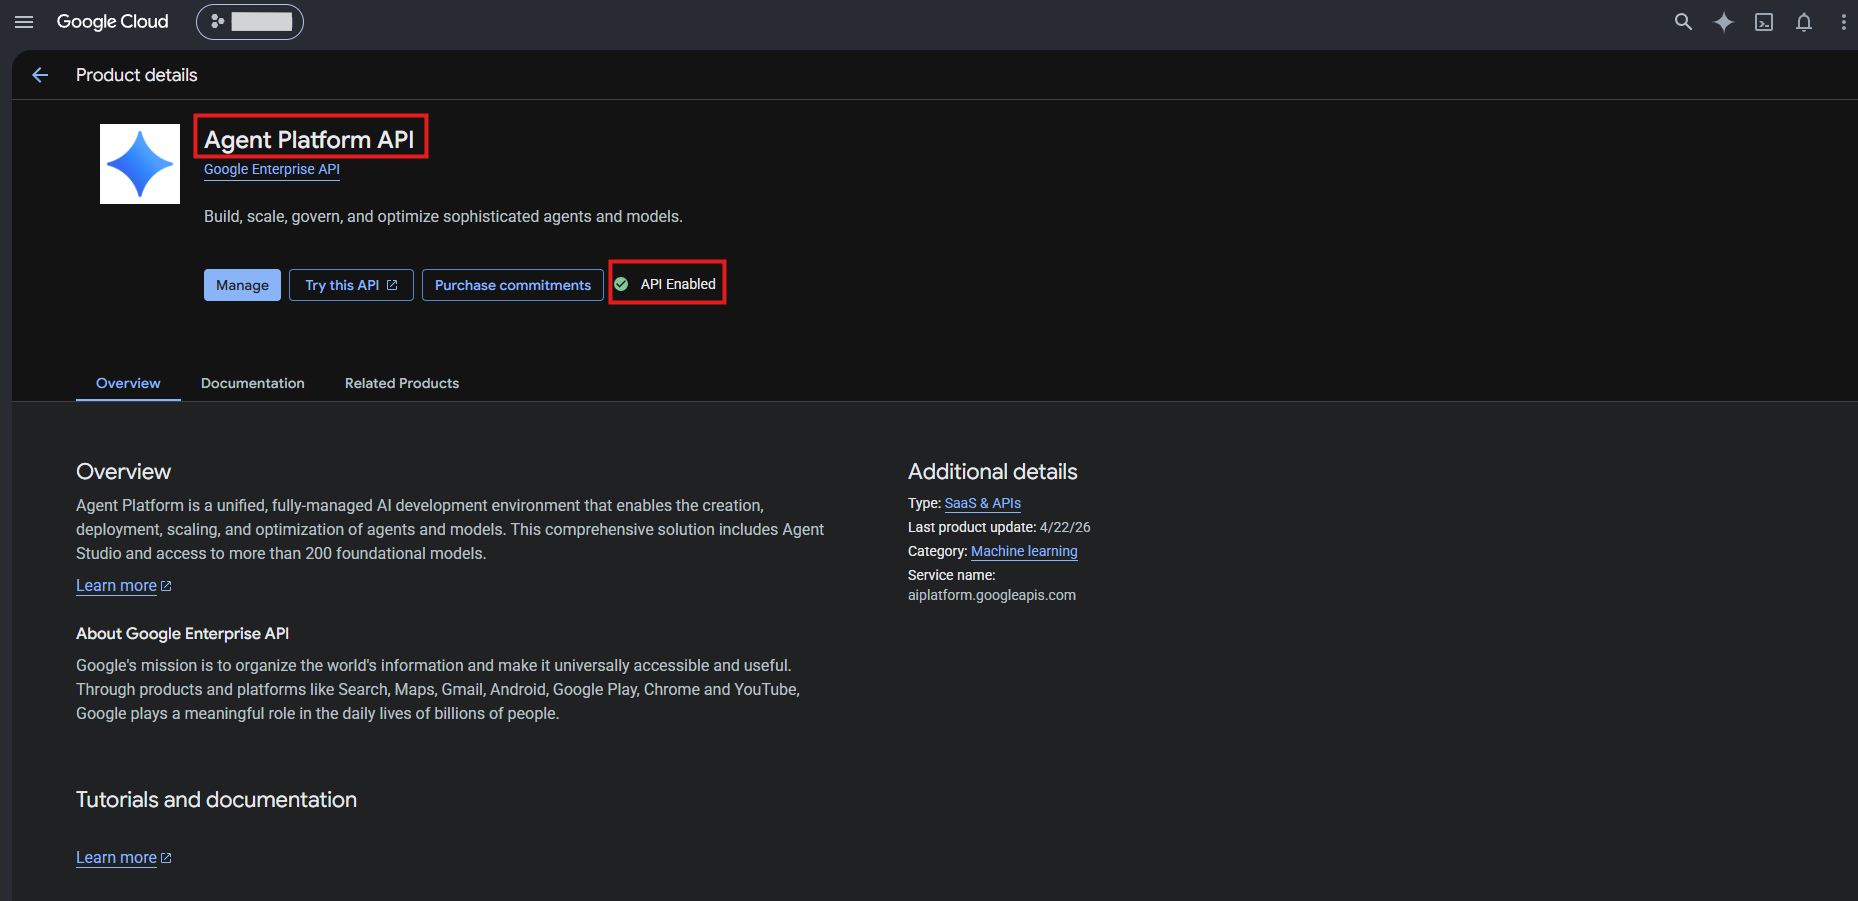
Option B : autoriser SecureAI sans clé
Avec l’option B, aucune clé n’est créée. À la place :- Dans SecureAI, ouvrez le panneau Vertex AI (voir l’étape 2), choisissez Keyless (impersonation) et saisissez l’adresse e-mail de votre compte de service dans Your service account to impersonate.
-
Le panneau affiche la commande à exécuter, déjà renseignée avec le compte de service SecureAI de votre déploiement. Copiez-la avec Copy et exécutez-la dans Cloud Shell. Elle ressemble à ceci :
Le rôle est accordé sur votre compte de service, et non sur le projet : SecureAI ne peut agir qu’en tant que ce compte, qui lui-même ne détient que
roles/aiplatform.user.
Modèles ouverts (Llama, DeepSeek, Qwen, gpt-oss)
Gemini ne demande rien de plus. Pour utiliser aussi Llama, DeepSeek, Qwen ou gpt-oss, acceptez d’abord les conditions de chaque modèle dans Vertex AI → Model Garden. Ces modèles ouverts nécessitent une région précise (par exempleus-central1) ; avec global, ils peuvent ne pas être disponibles.
Étape 2. Connecter le projet dans SecureAI
- Accédez à Admin → Integrations, ouvrez la catégorie AI providers et cliquez sur la carte Google Vertex AI — Inference on your account.
-
Sous Connection, renseignez :
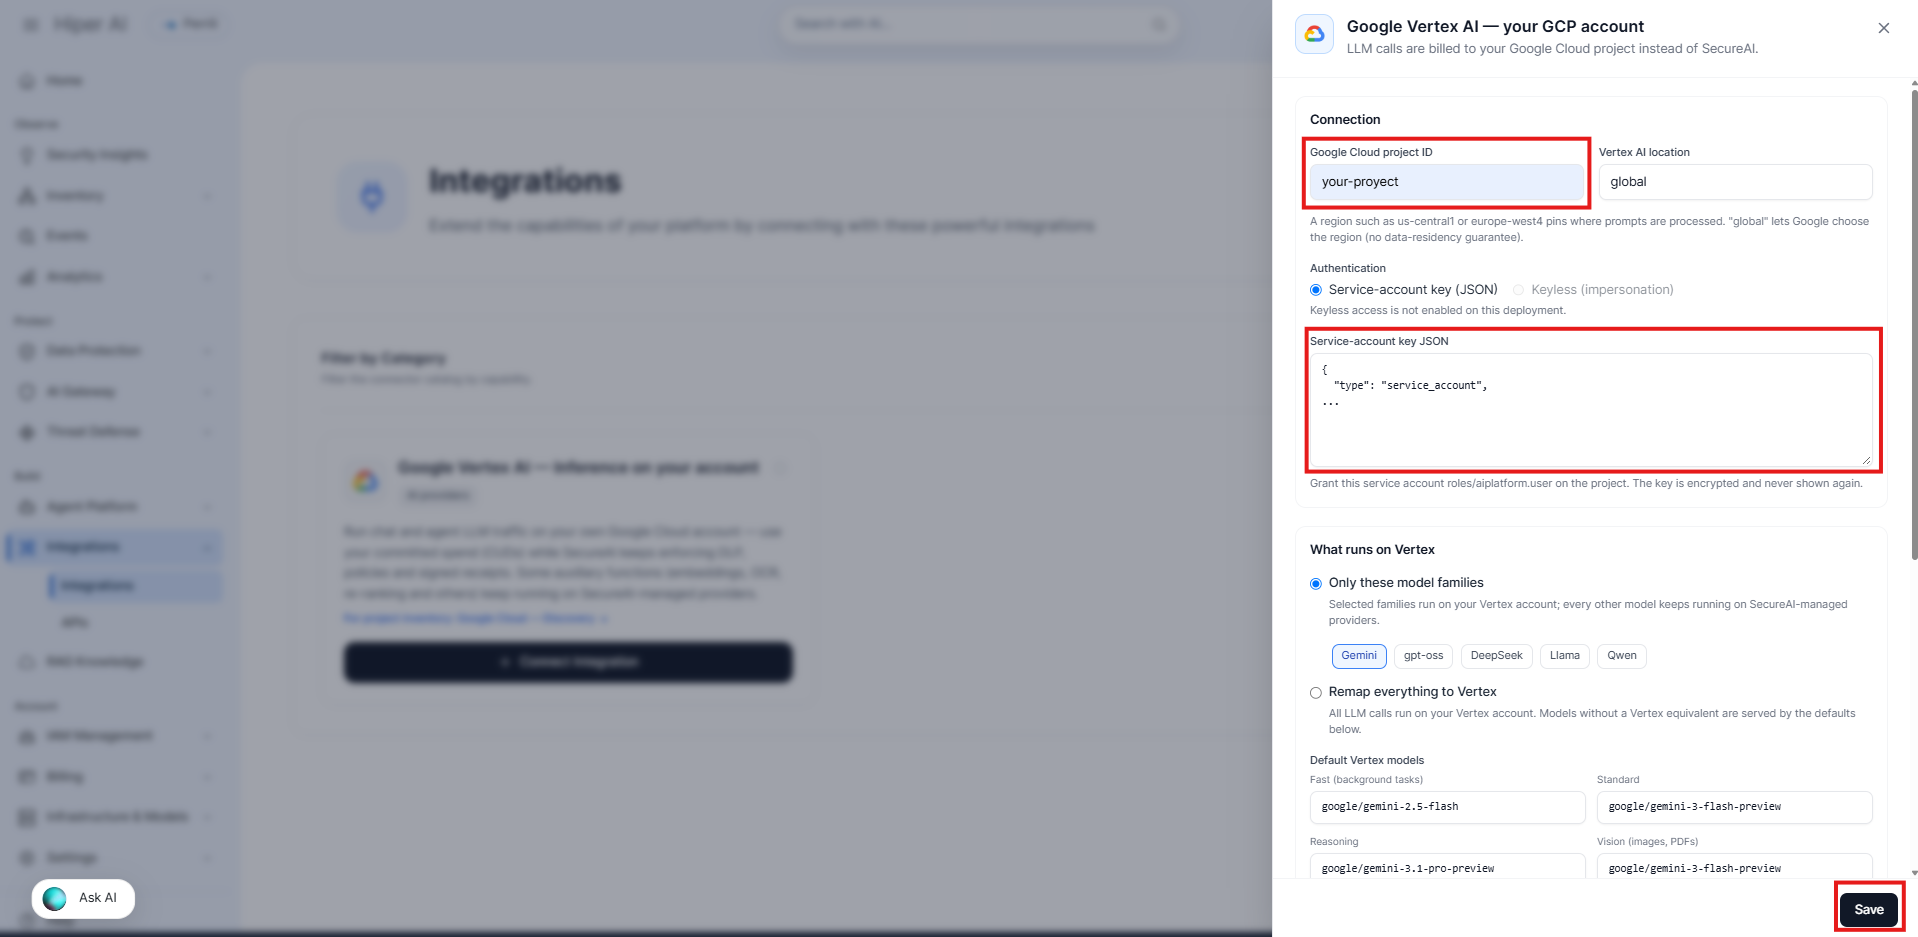
- Cliquez sur Save. Aucun trafic n’est encore routé : l’intégration est enregistrée désactivée pour que vous puissiez d’abord la tester.
Recommandation pour le premier jour : conservez le mode Only these model families avec Gemini uniquement, les modèles par défaut inchangés, et laissez désactivés le repli comme le plafond de dépenses par siège. C’est la configuration la plus prévisible. Gardez Remap everything pour quand tout cela aura été validé.
Avec l’option A, la clé collée n’est plus jamais affichée. Pour la remplacer, collez-en une nouvelle ; si vous laissez le champ vide lors de l’enregistrement, la clé actuelle est conservée.
Étape 3. Choisir ce qui s’exécute sur Vertex
Sous What runs on Vertex, il existe deux modes :- Only these model families — les familles que vous cochez (Gemini, gpt-oss, DeepSeek, Llama, Qwen) s’exécutent sur votre Vertex ; tous les autres modèles continuent de s’exécuter sur les fournisseurs de SecureAI. C’est la façon la plus prudente de commencer (par défaut : Gemini uniquement).
- Remap everything to Vertex — tous les appels LLM s’exécutent sur votre Vertex. Les modèles sans équivalent sur Vertex sont servis par un modèle par défaut.
Il existe aussi deux options :
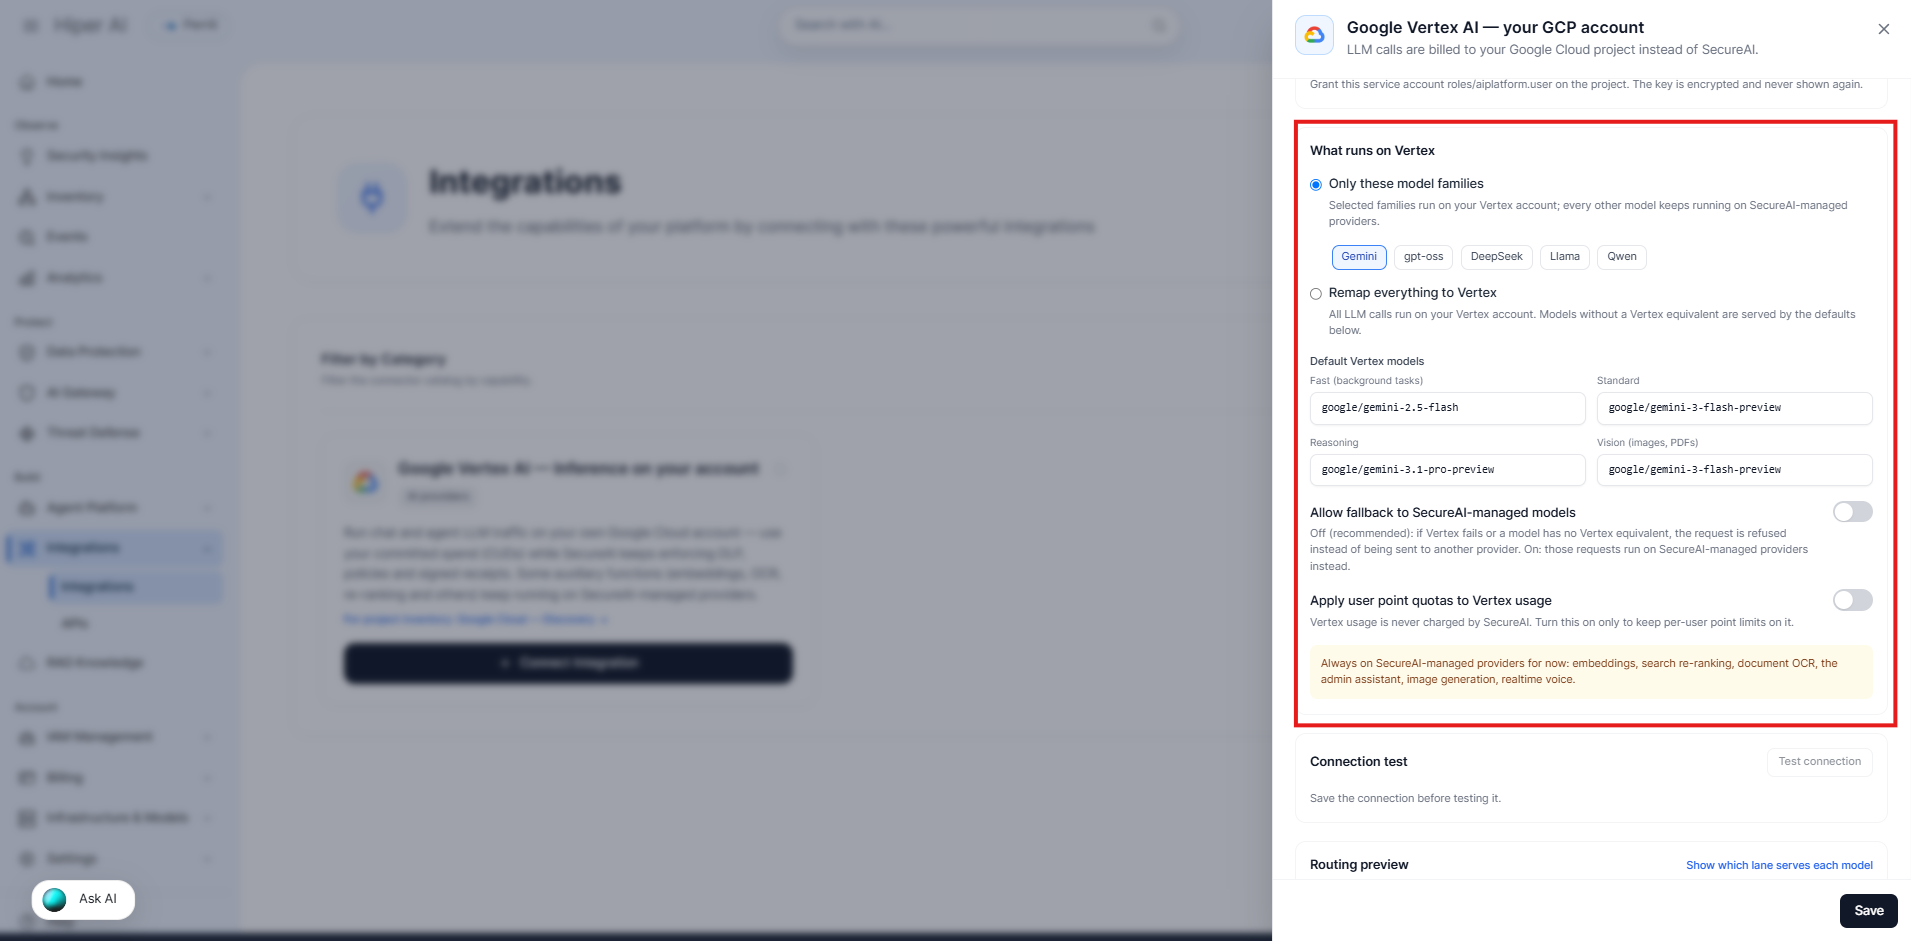
Les modèles disponibles dépendent de l’emplacement. Les modèles par défaut (dont plusieurs en preview) peuvent ne pas exister dans toutes les régions. Si le test de connexion renvoie Model not available in this location, choisissez une autre région ou remplacez les modèles par défaut par des modèles que votre région sert. Les modèles ouverts (MaaS) exigent d’accepter leurs conditions dans Vertex AI Model Garden et une région précise.
Étape 4. Tester la connexion
- Une fois l’intégration enregistrée, sous Connection test, cliquez sur Test connection.
-
SecureAI envoie une requête minimale à chaque modèle par défaut, par le même chemin que le trafic réel (passerelle, politiques et reçus compris), et affiche chaque résultat avec sa latence.
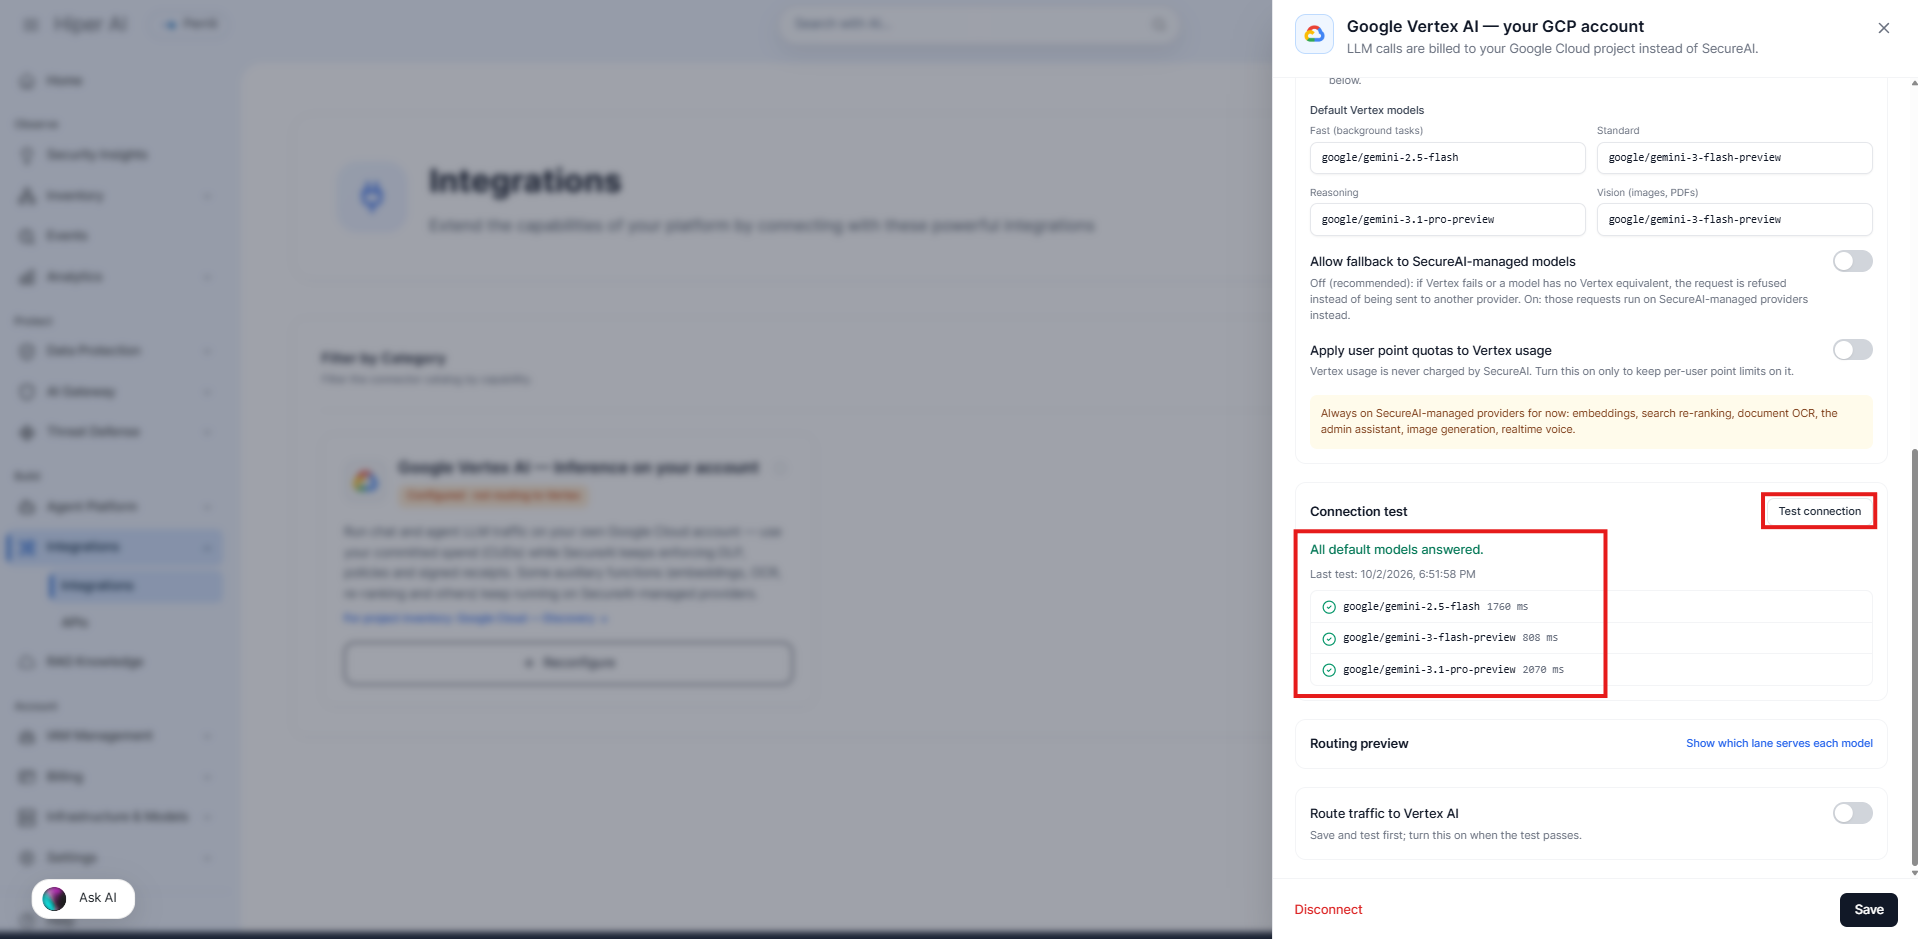
- Si un modèle échoue, le panneau en affiche la raison. Consultez la section Dépannage à la fin de cette page.
Ce que l’identité peut faire d’autre
Le test vérifie aussi ce que l’identité de la connexion peut faire d’autre dans le projet, avecprojects:testIamPermissions et le même jeton que le flux d’inférence : aucun rôle supplémentaire n’est nécessaire et rien n’est modifié. Le panneau affiche l’un de ces avis :
Le test envoie quelques requêtes d’un jeton et est facturé sur votre compte Google (quelques centimes).
Étape 5. Vérifier le routage et l’activer
- Ouvrez Routing preview → Show which lane serves each model. Pour chaque modèle du catalogue, l’aperçu indique s’il sera servi par votre Vertex (et avec quel modèle Vertex) ou par SecureAI, et lesquels seront masqués aux utilisateurs. L’aperçu simule l’intégration activée, ce qui vous permet d’examiner l’effet avant de l’activer.
-
Lorsque le test réussit, activez Route traffic to Vertex AI et cliquez de nouveau sur Save. Si vous n’enregistrez pas, l’interrupteur ne reste pas activé. Pour l’activer, un projet et un identifiant doivent être configurés. Si votre plan n’autorise pas un fournisseur cloud de plus ou si le routage en chevauche un autre, SecureAI le refuse et en explique la raison (voir Combien de fournisseurs cloud vous pouvez utiliser, ci-dessus).
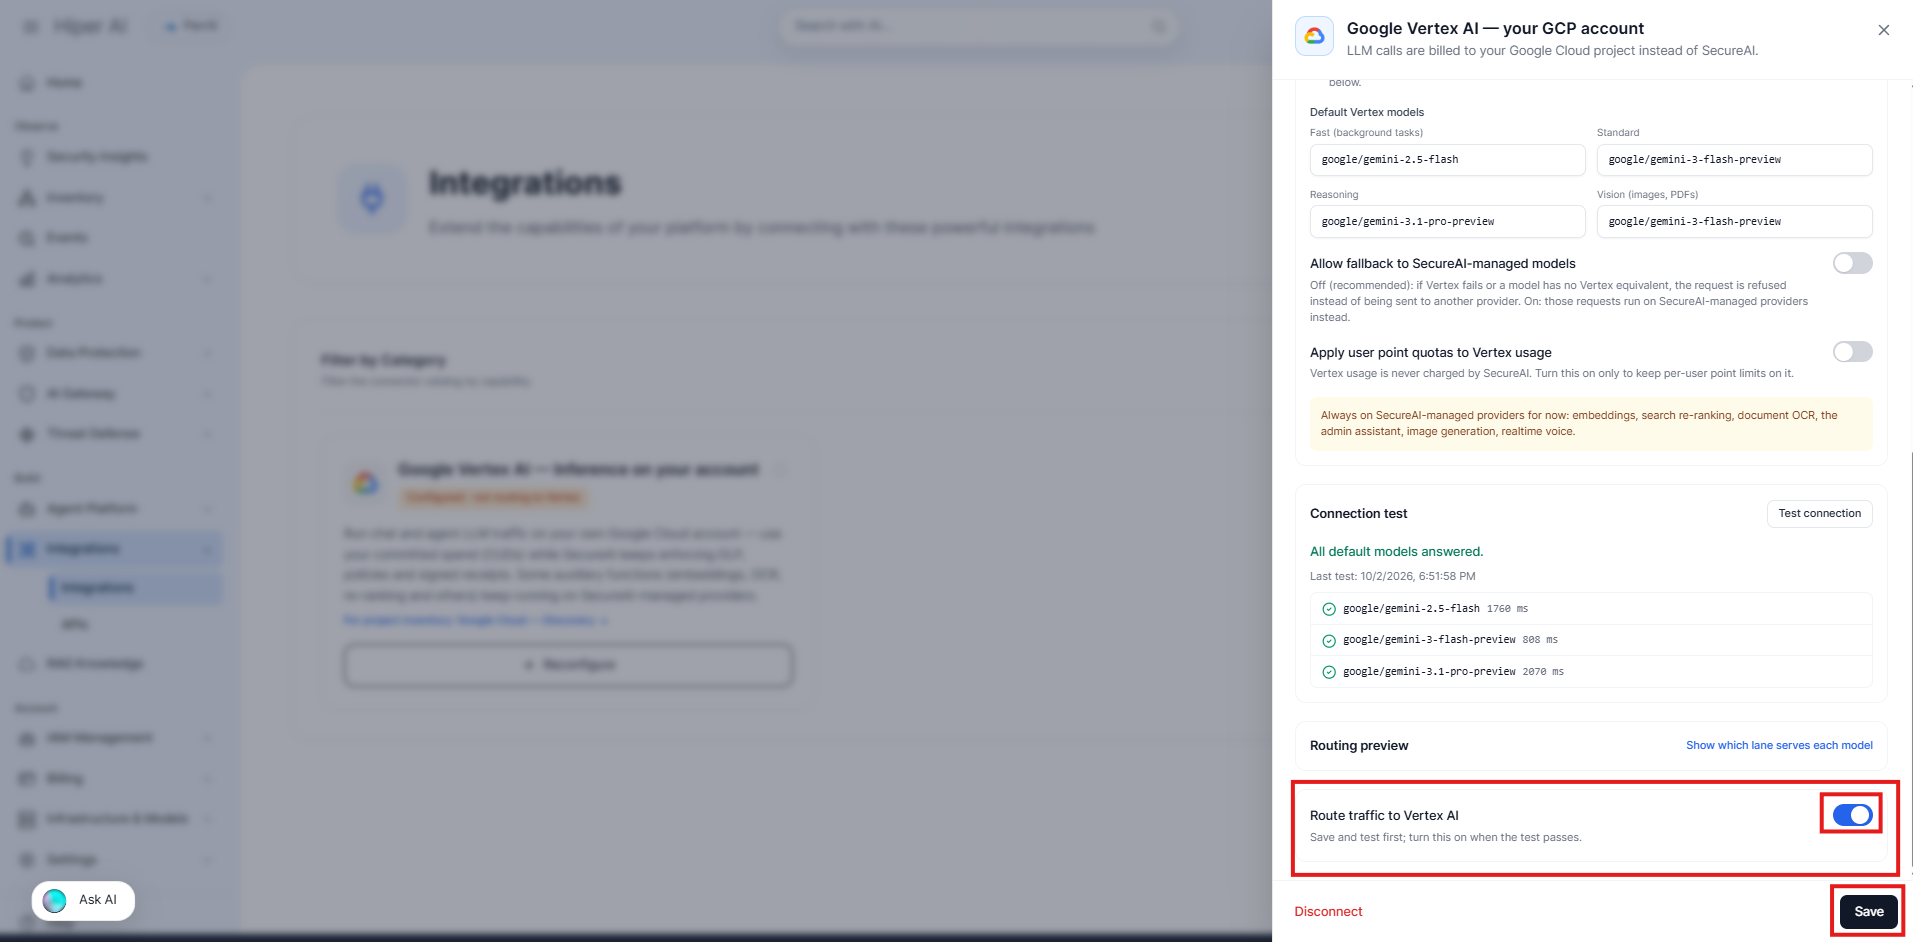
- La carte passe au vert : Routing to Vertex. Si elle est enregistrée mais désactivée, elle affiche en orange Configured · not routing to Vertex.
Étape 6. Vérifier dans le sélecteur de modèles
Lorsque l’intégration est active, les modèles qui s’exécutent sur votre Vertex affichent le logo Google Cloud à côté de leur nom dans le sélecteur de modèles du chat. Au survol, il indique que le modèle s’exécute sur le compte Vertex AI de votre organisation.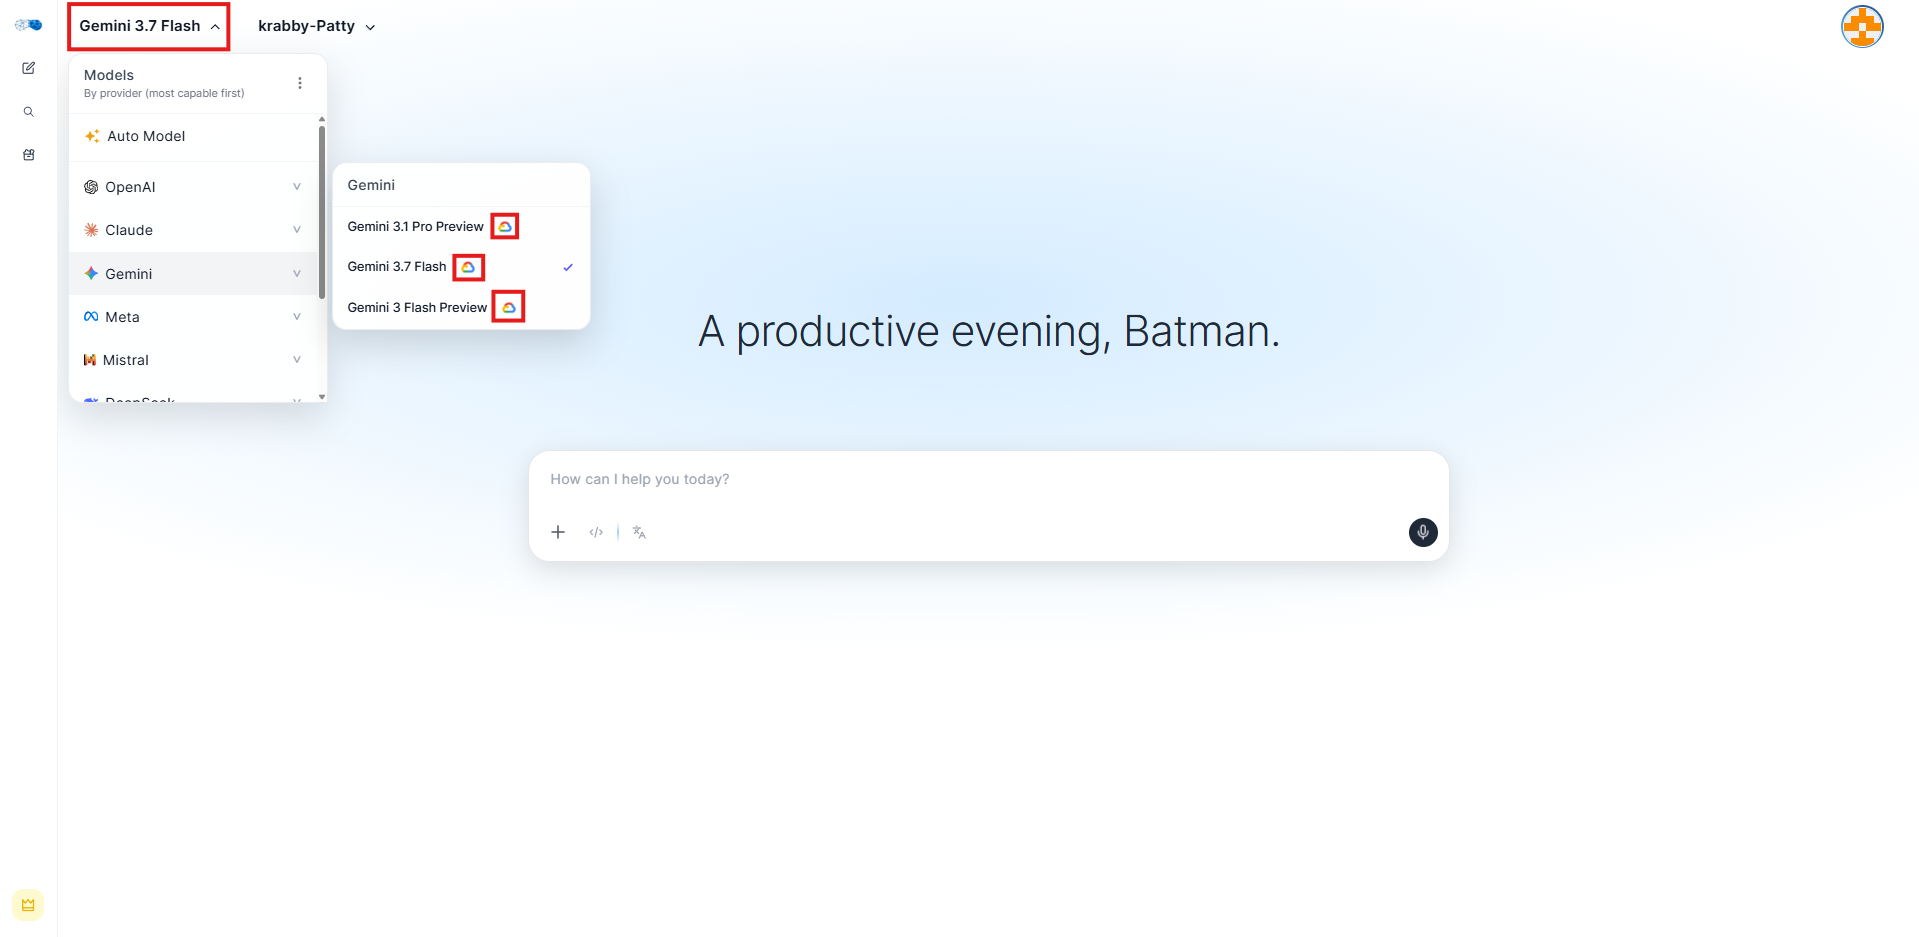
Ce qui est facturé, et à qui
- L’utilisation des LLM est facturée par Google sur votre compte, et non par SecureAI. Vous verrez le montant dans votre facturation Google Cloud, avec vos remises et vos CUD appliqués.
- SecureAI affiche le coût des tours servis sur Vertex sous forme d’estimation au prix catalogue, uniquement à des fins d’analyse. C’est une référence : elle n’inclut pas vos remises, donc le montant réel de Google peut être inférieur.
- Les tours servis sur votre Vertex ne sont pas décomptés du plafond de dépenses du siège de chaque utilisateur, sauf si vous activez Apply each seat’s spend cap to turns served in your account. Le niveau du siège continue de s’appliquer : un utilisateur ne peut utiliser que les modèles de son niveau ou d’un niveau inférieur, même lorsque votre Vertex les sert.
- Un siège Govern BYO ne peut utiliser que les modèles servis sur la propre infrastructure de votre organisation : ceux que sert votre Vertex (ou un autre fournisseur cloud connecté) et les modèles auto-hébergés sur vos serveurs. Tout autre modèle est refusé, et le sélecteur ne lui propose pas Auto.
Sécurité et conformité
- Identifiants chiffrés, ou aucun. Avec l’option A, la clé du compte de service est stockée chiffrée (AES-256-GCM) et n’est jamais renvoyée au navigateur, pas même à un administrateur ; l’écran n’affiche que l’adresse e-mail du compte. Avec l’option B, aucune clé n’est stockée : SecureAI demande à Google des jetons de courte durée qui agissent en tant que votre compte de service.
- Le chemin reste protégé. Chaque appel passe par la passerelle SMLTP de SecureAI : DLP, un jeton d’autorisation signé par requête et un reçu signé vérifiable.
- Résidence des données. Avec une région fixée (par exemple
europe-west4), SecureAI envoie chaque requête au point de terminaison de cette région et applique les politiques de résidence de votre organisation. Le lieu où Google traite la requête dépend des engagements de Google en matière de résidence des données. - Échec en mode fermé. Si la configuration ne peut pas être lue ou si le jeton de Google ne peut pas être obtenu, la requête est refusée ; elle n’est pas envoyée à un autre fournisseur, sauf si vous avez autorisé le repli.
- Audit. L’enregistrement, le test ou la déconnexion de l’intégration est consigné dans le journal d’activité, avec le nom des champs modifiés et jamais la clé.
- Moindre privilège visible. Le test de connexion vérifie ce que l’identité de la connexion peut faire d’autre dans le projet et avertit si elle détient des autorisations en dehors de l’IA (voir Ce que l’identité peut faire d’autre, à l’étape 4).
- Autorisations minimales.
roles/aiplatform.usersuffit pour l’inférence ; l’intégration n’a pas besoin de lire votre IAM ni votre facturation.
Déconnecter
Disconnect (pied du panneau) supprime la configuration et la clé stockée. À partir de ce moment, tout le trafic revient aux fournisseurs gérés par SecureAI. Vous pouvez aussi désactiver seulement l’interrupteur Route traffic to Vertex AI pour suspendre le routage tout en conservant la connexion. Retirez ensuite l’accès dans Google Cloud également :- Option A : si vous n’utilisez plus la clé, révoquez-la (Comptes de service → Clés).
- Option B : retirez le rôle
roles/iam.serviceAccountTokenCreatorque vous avez accordé au compte de service SecureAI sur votre compte de service (Comptes de service → votre compte → Autorisations).
Dépannage
Voici les raisons que Test connection peut afficher :
Erreurs que les utilisateurs peuvent voir dans le chat :
Limitations actuelles
- Claude et Mistral sur Vertex ne sont pas pris en charge (ils utilisent une API différente).
- Les embeddings, le reclassement, l’OCR, l’assistant d’administration, la génération d’images et la voix en temps réel restent sur les fournisseurs gérés par SecureAI.
- Un seul projet et un seul emplacement Vertex par organisation.
- Le nombre de fournisseurs d’inférence que vous pouvez activer en même temps dépend de votre plan (Scale : 1, Enterprise : jusqu’à 3). Voir Azure AI Foundry — Inference on your account et Amazon Bedrock — Inference on your account.
- Le proxy Claude Code utilise Anthropic directement et ne passe pas par Vertex.
Connexes
- Google Cloud — Discovery — inventaire des agents, des modèles, des identités et des coûts du projet.
- Azure AI Foundry — Inference on your account
- Amazon Bedrock — Inference on your account
- Présentation des fournisseurs Cloud AI
- Reçus signés